

Upload folder using huggingface_hub
Browse files- .gitattributes +1 -0
- README.md +56 -0
- bert-base-chinese/config.json +26 -0
- bert-base-chinese/config_decoder.json +28 -0
- bert-base-chinese/pytorch_model.bin +3 -0
- bert-base-chinese/tokenizer.json +0 -0
- bert-base-chinese/tokenizer_config.json +1 -0
- bert-base-chinese/vocab.txt +0 -0
- bert-base-uncased/config.json +24 -0
- bert-base-uncased/config_decoder.json +26 -0
- bert-base-uncased/model.safetensors +3 -0
- bert-base-uncased/pytorch_model.bin +3 -0
- bert-base-uncased/tokenizer.json +0 -0
- bert-base-uncased/tokenizer_config.json +3 -0
- bert-base-uncased/vocab.txt +0 -0
- checkpoint_radar_plus.pth +3 -0
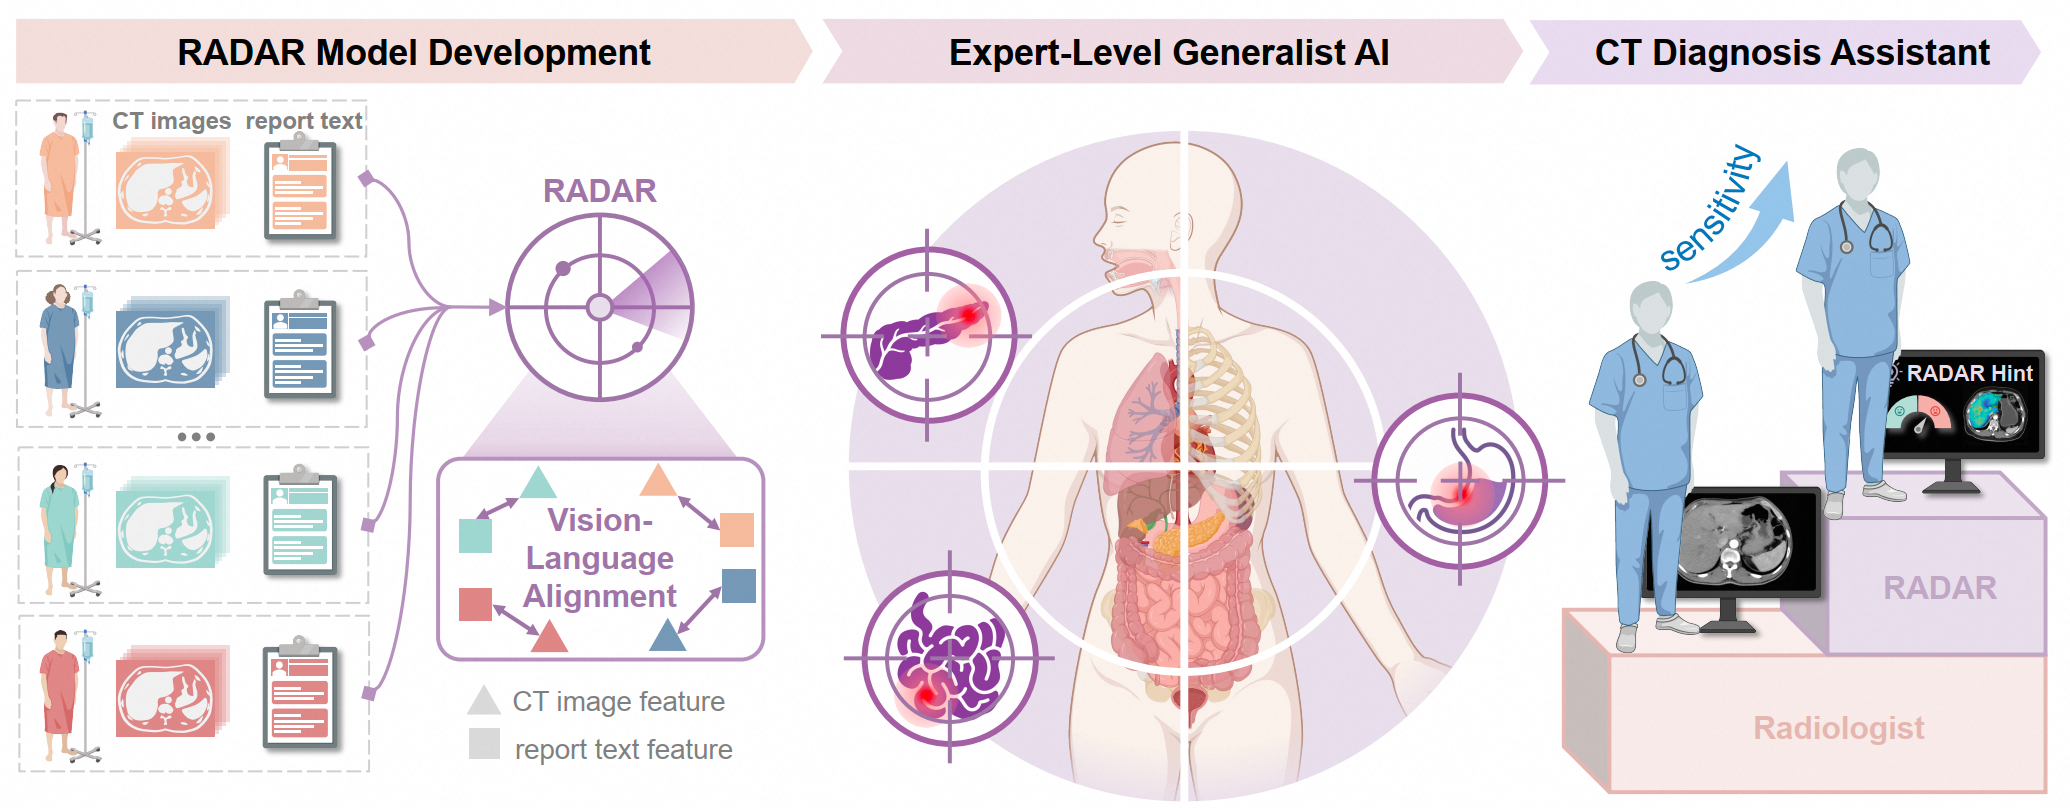
- checkpoint_radar_plus_finetuned_on_merlin.pth +3 -0
- checkpoint_radar_pretrain.pth +3 -0
- checkpoint_unet.pth +3 -0
- radar_fig0.png +3 -0
.gitattributes
CHANGED
|
@@ -33,3 +33,4 @@ saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
|
|
|
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
| 36 |
+
radar_fig0.png filter=lfs diff=lfs merge=lfs -text
|
README.md
CHANGED
|
@@ -1,3 +1,59 @@
|
|
| 1 |
---
|
| 2 |
license: cc-by-nc-sa-4.0
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 3 |
---
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
---
|
| 2 |
license: cc-by-nc-sa-4.0
|
| 3 |
+
language:
|
| 4 |
+
- en
|
| 5 |
+
tags:
|
| 6 |
+
- vision-language pretraining
|
| 7 |
+
- medical
|
| 8 |
+
- ct diagnosis
|
| 9 |
---
|
| 10 |
+
|
| 11 |
+
# RADAR: An Expert-Level Generalist AI for Abdominal CT Diagnosis
|
| 12 |
+
[](https://www.science.org/doi/10.1126/science.aec6129)
|
| 13 |
+
[](https://github.com/alibaba-damo-academy/damo-radar)
|
| 14 |
+
[](https://zenodo.org/records/21271172)
|
| 15 |
+
[](https://creativecommons.org/licenses/by-nc-sa/4.0/)
|
| 16 |
+
|
| 17 |
+
RADAR is a generalist vision-language model trained on over 400,000 contrast-enhanced abdominal CT examinations with 15 million anatomy-aware image–text pairs, learning directly from clinical reports without manual annotation. RADAR provides a scalable and versatile framework for radiology AI, demonstrating expert-level performance across both routine and complex clinical tasks.
|
| 18 |
+
|
| 19 |
+
<p align="center">
|
| 20 |
+
<img src="radar_fig0.png" alt="RADAR Overview" width="90%">
|
| 21 |
+
</p>
|
| 22 |
+
|
| 23 |
+
## Model Preparation
|
| 24 |
+
|
| 25 |
+
Pre-trained checkpoints are available on [HuggingFace](https://huggingface.co/datasets/radar-generalist/RADAR).
|
| 26 |
+
|
| 27 |
+
| File | Description | Destination |
|
| 28 |
+
| --- | --- | --- |
|
| 29 |
+
| `checkpoint_radar_pretrain.pth` | RADAR pre-trained on RAD-CT | `radar/ckpt/checkpoint_radar_pretrain.pth` |
|
| 30 |
+
| `bert-base-chinese` | BERT tokenizer and model (Chinese) | `radar/ckpt/bert-base-chinese/` |
|
| 31 |
+
| `bert-base-uncased` | BERT tokenizer and model (English) | `radar/ckpt/bert-base-uncased/` |
|
| 32 |
+
| `checkpoint_unet.pth` | Pretrained VisionBranch (UNet) checkpoint | `radar/ckpt/checkpoint_unet.pth` |
|
| 33 |
+
| `checkpoint_radar_plus.pth` | RADAR+ checkpoint trained from scratch on Merlin-CT-Train | `radar/ckpt/checkpoint_radar_plus.pth` |
|
| 34 |
+
| `checkpoint_radar_plus_finetuned_on_merlin.pth` | RADAR+ checkpoint pretrained on RAD-CT and finetuned on Merlin-CT-Train | `radar/ckpt/checkpoint_radar_plus_finetuned_on_merlin.pth` |
|
| 35 |
+
|
| 36 |
+
## License
|
| 37 |
+
|
| 38 |
+
This project is released under the [CC BY-NC-SA 4.0](https://creativecommons.org/licenses/by-nc-sa/4.0/).
|
| 39 |
+
|
| 40 |
+
> The Radar model is currently intended for research purposes only. Further improvements and prospective clinical studies are still required before it can be used directly for clinical deployment.
|
| 41 |
+
|
| 42 |
+
|
| 43 |
+
## Citation
|
| 44 |
+
|
| 45 |
+
If you use these models in your research, please cite:
|
| 46 |
+
|
| 47 |
+
```bibtex
|
| 48 |
+
@article{damo-radar-2026,
|
| 49 |
+
author = {Qi Zhang and Jianpeng Zhang and Weiwei Cao and Zilin Lu and Wanxing Chang and Haonan Ding and Cao Chen and Zhi Li and Xing Xue and Sinuo Wang and Shaoteng Zhang and Yutong Xie and Yong Xia and Qi Wu and Zhongyi Shui and Xi Li and Zhilin Zheng and Yanjie Zhou and Tony C.W. Mok and Yingda Xia and Hongkan Wang and Xianghua Ye and Tao Ma and Jie Peng and Xiaoguang Wang and Jian Ding and Yuming Gao and Huazhen Ye and Yiping Liu and Dongjie Chen and Zhaomin Ni and Jianwen Ning and Wei Zhang and Jian Liu and Chaohui Yu and Shenghong Ju and Jianfeng Zhang and Wenbo Xiao and Ling Zhang and Tingbo Liang },
|
| 50 |
+
title = {An expert-level generalist AI for abdominal CT diagnosis},
|
| 51 |
+
journal = {Science},
|
| 52 |
+
volume = {393},
|
| 53 |
+
number = {6817},
|
| 54 |
+
pages = {eaec6129},
|
| 55 |
+
year = {2026},
|
| 56 |
+
doi = {10.1126/science.aec6129},
|
| 57 |
+
URL = {https://www.science.org/doi/abs/10.1126/science.aec6129}
|
| 58 |
+
}
|
| 59 |
+
```
|
bert-base-chinese/config.json
ADDED
|
@@ -0,0 +1,26 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"architectures": [
|
| 3 |
+
"BertForMaskedLM"
|
| 4 |
+
],
|
| 5 |
+
"attention_probs_dropout_prob": 0.1,
|
| 6 |
+
"directionality": "bidi",
|
| 7 |
+
"hidden_act": "gelu",
|
| 8 |
+
"hidden_dropout_prob": 0.1,
|
| 9 |
+
"hidden_size": 768,
|
| 10 |
+
"initializer_range": 0.02,
|
| 11 |
+
"intermediate_size": 3072,
|
| 12 |
+
"layer_norm_eps": 1e-12,
|
| 13 |
+
"max_position_embeddings": 512,
|
| 14 |
+
"model_type": "bert",
|
| 15 |
+
"num_attention_heads": 12,
|
| 16 |
+
"num_hidden_layers": 12,
|
| 17 |
+
"pad_token_id": 0,
|
| 18 |
+
"pooler_fc_size": 768,
|
| 19 |
+
"pooler_num_attention_heads": 12,
|
| 20 |
+
"pooler_num_fc_layers": 3,
|
| 21 |
+
"pooler_size_per_head": 128,
|
| 22 |
+
"pooler_type": "first_token_transform",
|
| 23 |
+
"type_vocab_size": 2,
|
| 24 |
+
"vocab_size": 21128,
|
| 25 |
+
"add_type_embeddings": false
|
| 26 |
+
}
|
bert-base-chinese/config_decoder.json
ADDED
|
@@ -0,0 +1,28 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"architectures": [
|
| 3 |
+
"BertForMaskedLM"
|
| 4 |
+
],
|
| 5 |
+
"attention_probs_dropout_prob": 0.1,
|
| 6 |
+
"directionality": "bidi",
|
| 7 |
+
"hidden_act": "gelu",
|
| 8 |
+
"hidden_dropout_prob": 0.1,
|
| 9 |
+
"hidden_size": 768,
|
| 10 |
+
"initializer_range": 0.02,
|
| 11 |
+
"intermediate_size": 3072,
|
| 12 |
+
"layer_norm_eps": 1e-12,
|
| 13 |
+
"max_position_embeddings": 512,
|
| 14 |
+
"model_type": "bert",
|
| 15 |
+
"num_attention_heads": 12,
|
| 16 |
+
"num_hidden_layers": 12,
|
| 17 |
+
"pad_token_id": 0,
|
| 18 |
+
"pooler_fc_size": 768,
|
| 19 |
+
"pooler_num_attention_heads": 12,
|
| 20 |
+
"pooler_num_fc_layers": 3,
|
| 21 |
+
"pooler_size_per_head": 128,
|
| 22 |
+
"pooler_type": "first_token_transform",
|
| 23 |
+
"type_vocab_size": 2,
|
| 24 |
+
"vocab_size": 21128,
|
| 25 |
+
"add_type_embeddings": false,
|
| 26 |
+
"encoder_width": 768,
|
| 27 |
+
"add_cross_attention": true
|
| 28 |
+
}
|
bert-base-chinese/pytorch_model.bin
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:8a693db616eaf647ed2bfe531e1fa446637358fc108a8bf04e8d4db17e837ee9
|
| 3 |
+
size 411577189
|
bert-base-chinese/tokenizer.json
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|
bert-base-chinese/tokenizer_config.json
ADDED
|
@@ -0,0 +1 @@
|
|
|
|
|
|
|
| 1 |
+
{"do_lower_case": false, "model_max_length": 512}
|
bert-base-chinese/vocab.txt
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|
bert-base-uncased/config.json
ADDED
|
@@ -0,0 +1,24 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"architectures": [
|
| 3 |
+
"BertForMaskedLM"
|
| 4 |
+
],
|
| 5 |
+
"attention_probs_dropout_prob": 0.1,
|
| 6 |
+
"gradient_checkpointing": false,
|
| 7 |
+
"hidden_act": "gelu",
|
| 8 |
+
"hidden_dropout_prob": 0.1,
|
| 9 |
+
"hidden_size": 768,
|
| 10 |
+
"initializer_range": 0.02,
|
| 11 |
+
"intermediate_size": 3072,
|
| 12 |
+
"layer_norm_eps": 1e-12,
|
| 13 |
+
"max_position_embeddings": 512,
|
| 14 |
+
"model_type": "bert",
|
| 15 |
+
"num_attention_heads": 12,
|
| 16 |
+
"num_hidden_layers": 12,
|
| 17 |
+
"pad_token_id": 0,
|
| 18 |
+
"position_embedding_type": "absolute",
|
| 19 |
+
"transformers_version": "4.6.0.dev0",
|
| 20 |
+
"type_vocab_size": 2,
|
| 21 |
+
"use_cache": true,
|
| 22 |
+
"vocab_size": 30522,
|
| 23 |
+
"add_type_embeddings": false
|
| 24 |
+
}
|
bert-base-uncased/config_decoder.json
ADDED
|
@@ -0,0 +1,26 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"architectures": [
|
| 3 |
+
"BertForMaskedLM"
|
| 4 |
+
],
|
| 5 |
+
"attention_probs_dropout_prob": 0.1,
|
| 6 |
+
"gradient_checkpointing": false,
|
| 7 |
+
"hidden_act": "gelu",
|
| 8 |
+
"hidden_dropout_prob": 0.1,
|
| 9 |
+
"hidden_size": 768,
|
| 10 |
+
"initializer_range": 0.02,
|
| 11 |
+
"intermediate_size": 3072,
|
| 12 |
+
"layer_norm_eps": 1e-12,
|
| 13 |
+
"max_position_embeddings": 512,
|
| 14 |
+
"model_type": "bert",
|
| 15 |
+
"num_attention_heads": 12,
|
| 16 |
+
"num_hidden_layers": 12,
|
| 17 |
+
"pad_token_id": 0,
|
| 18 |
+
"position_embedding_type": "absolute",
|
| 19 |
+
"transformers_version": "4.6.0.dev0",
|
| 20 |
+
"type_vocab_size": 2,
|
| 21 |
+
"use_cache": true,
|
| 22 |
+
"vocab_size": 30522,
|
| 23 |
+
"add_type_embeddings": false,
|
| 24 |
+
"encoder_width": 768,
|
| 25 |
+
"add_cross_attention": true
|
| 26 |
+
}
|
bert-base-uncased/model.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:68d45e234eb4a928074dfd868cead0219ab85354cc53d20e772753c6bb9169d3
|
| 3 |
+
size 440449768
|
bert-base-uncased/pytorch_model.bin
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:097417381d6c7230bd9e3557456d726de6e83245ec8b24f529f60198a67b203a
|
| 3 |
+
size 440473133
|
bert-base-uncased/tokenizer.json
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|
bert-base-uncased/tokenizer_config.json
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"do_lower_case": true
|
| 3 |
+
}
|
bert-base-uncased/vocab.txt
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|
checkpoint_radar_plus.pth
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:4dd201111000fa11085d49eddf287520a37cc76288eaca93eab8f8510480f15a
|
| 3 |
+
size 1651336682
|
checkpoint_radar_plus_finetuned_on_merlin.pth
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:cd5aae5635de3712312c067dd82114cd4c215e7dcfc11eb3619dab73fcceaebc
|
| 3 |
+
size 1651335230
|
checkpoint_radar_pretrain.pth
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:5e8b1b50b92162fcafcf8231e51ffbe9d1be2be52ccff4f967e4beb71e4499f4
|
| 3 |
+
size 1566049482
|
checkpoint_unet.pth
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:052bbe8cbbc5d23859cb8fe1935249e94c1ef733e8e4a79153e9fc8988e84985
|
| 3 |
+
size 208341958
|
radar_fig0.png
ADDED
|
Git LFS Details
|