

Upload 18 files
Browse files- .gitattributes +1 -0
- README.md +72 -3
- adapter_config.json +42 -0
- adapter_model.safetensors +3 -0
- added_tokens.json +24 -0
- all_results.json +12 -0
- chat_template.jinja +54 -0
- eval_results.json +7 -0
- merges.txt +0 -0
- special_tokens_map.json +31 -0
- tokenizer.json +3 -0
- tokenizer_config.json +208 -0
- train_results.json +8 -0
- trainer_log.jsonl +14 -0
- trainer_state.json +136 -0
- training_args.bin +3 -0
- training_eval_loss.png +0 -0
- training_loss.png +0 -0
- vocab.json +0 -0
.gitattributes
CHANGED
|
@@ -33,3 +33,4 @@ saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
|
|
|
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
| 36 |
+
tokenizer.json filter=lfs diff=lfs merge=lfs -text
|
README.md
CHANGED
|
@@ -1,3 +1,72 @@
|
|
| 1 |
-
---
|
| 2 |
-
|
| 3 |
-
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
---
|
| 2 |
+
library_name: peft
|
| 3 |
+
license: other
|
| 4 |
+
base_model: Qwen/Qwen2.5-Coder-7B
|
| 5 |
+
tags:
|
| 6 |
+
- base_model:adapter:Qwen/Qwen2.5-Coder-7B
|
| 7 |
+
- llama-factory
|
| 8 |
+
- lora
|
| 9 |
+
- transformers
|
| 10 |
+
pipeline_tag: text-generation
|
| 11 |
+
model-index:
|
| 12 |
+
- name: sft_v2_61w
|
| 13 |
+
results: []
|
| 14 |
+
---
|
| 15 |
+
|
| 16 |
+
<!-- This model card has been generated automatically according to the information the Trainer had access to. You
|
| 17 |
+
should probably proofread and complete it, then remove this comment. -->
|
| 18 |
+
|
| 19 |
+
本项工作在同元软控实习期间完成,旨在通过微调得到更适配 Julia 语言的大模型。
|
| 20 |
+
|
| 21 |
+
# sft_v2_61w
|
| 22 |
+
|
| 23 |
+
This model is a fine-tuned version of [Qwen/Qwen2.5-Coder-7B](https://huggingface.co/Qwen/Qwen2.5-Coder-7B) on the julia_func_datasetv2_61w dataset.
|
| 24 |
+
It achieves the following results on the evaluation set:
|
| 25 |
+
- Loss: 0.9146
|
| 26 |
+
|
| 27 |
+
## Model description
|
| 28 |
+
|
| 29 |
+
More information needed
|
| 30 |
+
|
| 31 |
+
## Intended uses & limitations
|
| 32 |
+
|
| 33 |
+
More information needed
|
| 34 |
+
|
| 35 |
+
## Training and evaluation data
|
| 36 |
+
|
| 37 |
+
More information needed
|
| 38 |
+
|
| 39 |
+
## Training procedure
|
| 40 |
+
|
| 41 |
+
### Training hyperparameters
|
| 42 |
+
|
| 43 |
+
The following hyperparameters were used during training:
|
| 44 |
+
- learning_rate: 0.0001
|
| 45 |
+
- train_batch_size: 4
|
| 46 |
+
- eval_batch_size: 4
|
| 47 |
+
- seed: 42
|
| 48 |
+
- distributed_type: multi-GPU
|
| 49 |
+
- num_devices: 4
|
| 50 |
+
- gradient_accumulation_steps: 8
|
| 51 |
+
- total_train_batch_size: 128
|
| 52 |
+
- total_eval_batch_size: 16
|
| 53 |
+
- optimizer: Use adamw_torch_fused with betas=(0.9,0.999) and epsilon=1e-08 and optimizer_args=No additional optimizer arguments
|
| 54 |
+
- lr_scheduler_type: cosine
|
| 55 |
+
- lr_scheduler_warmup_ratio: 0.1
|
| 56 |
+
- num_epochs: 2
|
| 57 |
+
|
| 58 |
+
### Training results
|
| 59 |
+
|
| 60 |
+
| Training Loss | Epoch | Step | Validation Loss |
|
| 61 |
+
|:-------------:|:------:|:----:|:---------------:|
|
| 62 |
+
| 0.9108 | 0.8828 | 4000 | 0.9155 |
|
| 63 |
+
| 0.904 | 1.7654 | 8000 | 0.9145 |
|
| 64 |
+
|
| 65 |
+
|
| 66 |
+
### Framework versions
|
| 67 |
+
|
| 68 |
+
- PEFT 0.17.1
|
| 69 |
+
- Transformers 4.56.2
|
| 70 |
+
- Pytorch 2.8.0+cu128
|
| 71 |
+
- Datasets 4.0.0
|
| 72 |
+
- Tokenizers 0.22.1
|
adapter_config.json
ADDED
|
@@ -0,0 +1,42 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"alpha_pattern": {},
|
| 3 |
+
"auto_mapping": null,
|
| 4 |
+
"base_model_name_or_path": "Qwen/Qwen2.5-Coder-7B",
|
| 5 |
+
"bias": "none",
|
| 6 |
+
"corda_config": null,
|
| 7 |
+
"eva_config": null,
|
| 8 |
+
"exclude_modules": null,
|
| 9 |
+
"fan_in_fan_out": false,
|
| 10 |
+
"inference_mode": true,
|
| 11 |
+
"init_lora_weights": true,
|
| 12 |
+
"layer_replication": null,
|
| 13 |
+
"layers_pattern": null,
|
| 14 |
+
"layers_to_transform": null,
|
| 15 |
+
"loftq_config": {},
|
| 16 |
+
"lora_alpha": 16,
|
| 17 |
+
"lora_bias": false,
|
| 18 |
+
"lora_dropout": 0.0,
|
| 19 |
+
"megatron_config": null,
|
| 20 |
+
"megatron_core": "megatron.core",
|
| 21 |
+
"modules_to_save": null,
|
| 22 |
+
"peft_type": "LORA",
|
| 23 |
+
"qalora_group_size": 16,
|
| 24 |
+
"r": 8,
|
| 25 |
+
"rank_pattern": {},
|
| 26 |
+
"revision": null,
|
| 27 |
+
"target_modules": [
|
| 28 |
+
"v_proj",
|
| 29 |
+
"q_proj",
|
| 30 |
+
"k_proj",
|
| 31 |
+
"up_proj",
|
| 32 |
+
"down_proj",
|
| 33 |
+
"gate_proj",
|
| 34 |
+
"o_proj"
|
| 35 |
+
],
|
| 36 |
+
"target_parameters": null,
|
| 37 |
+
"task_type": "CAUSAL_LM",
|
| 38 |
+
"trainable_token_indices": null,
|
| 39 |
+
"use_dora": false,
|
| 40 |
+
"use_qalora": false,
|
| 41 |
+
"use_rslora": false
|
| 42 |
+
}
|
adapter_model.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:c3dfbb80bb1f2e31bbfbebe0b9ed5143d7f399d1bf1fa602b8bcf85eb199e1df
|
| 3 |
+
size 80792096
|
added_tokens.json
ADDED
|
@@ -0,0 +1,24 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"</tool_call>": 151658,
|
| 3 |
+
"<tool_call>": 151657,
|
| 4 |
+
"<|box_end|>": 151649,
|
| 5 |
+
"<|box_start|>": 151648,
|
| 6 |
+
"<|endoftext|>": 151643,
|
| 7 |
+
"<|file_sep|>": 151664,
|
| 8 |
+
"<|fim_middle|>": 151660,
|
| 9 |
+
"<|fim_pad|>": 151662,
|
| 10 |
+
"<|fim_prefix|>": 151659,
|
| 11 |
+
"<|fim_suffix|>": 151661,
|
| 12 |
+
"<|im_end|>": 151645,
|
| 13 |
+
"<|im_start|>": 151644,
|
| 14 |
+
"<|image_pad|>": 151655,
|
| 15 |
+
"<|object_ref_end|>": 151647,
|
| 16 |
+
"<|object_ref_start|>": 151646,
|
| 17 |
+
"<|quad_end|>": 151651,
|
| 18 |
+
"<|quad_start|>": 151650,
|
| 19 |
+
"<|repo_name|>": 151663,
|
| 20 |
+
"<|video_pad|>": 151656,
|
| 21 |
+
"<|vision_end|>": 151653,
|
| 22 |
+
"<|vision_pad|>": 151654,
|
| 23 |
+
"<|vision_start|>": 151652
|
| 24 |
+
}
|
all_results.json
ADDED
|
@@ -0,0 +1,12 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"epoch": 2.0,
|
| 3 |
+
"eval_loss": 0.9146204590797424,
|
| 4 |
+
"eval_runtime": 247.06,
|
| 5 |
+
"eval_samples_per_second": 121.428,
|
| 6 |
+
"eval_steps_per_second": 7.589,
|
| 7 |
+
"total_flos": 1.2106519982783857e+19,
|
| 8 |
+
"train_loss": 0.9370549143886313,
|
| 9 |
+
"train_runtime": 28045.4399,
|
| 10 |
+
"train_samples_per_second": 41.361,
|
| 11 |
+
"train_steps_per_second": 0.323
|
| 12 |
+
}
|
chat_template.jinja
ADDED
|
@@ -0,0 +1,54 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{%- if tools %}
|
| 2 |
+
{{- '<|im_start|>system\n' }}
|
| 3 |
+
{%- if messages[0]['role'] == 'system' %}
|
| 4 |
+
{{- messages[0]['content'] }}
|
| 5 |
+
{%- else %}
|
| 6 |
+
{{- 'You are Qwen, created by Alibaba Cloud. You are a helpful assistant.' }}
|
| 7 |
+
{%- endif %}
|
| 8 |
+
{{- "\n\n# Tools\n\nYou may call one or more functions to assist with the user query.\n\nYou are provided with function signatures within <tools></tools> XML tags:\n<tools>" }}
|
| 9 |
+
{%- for tool in tools %}
|
| 10 |
+
{{- "\n" }}
|
| 11 |
+
{{- tool | tojson }}
|
| 12 |
+
{%- endfor %}
|
| 13 |
+
{{- "\n</tools>\n\nFor each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:\n<tool_call>\n{\"name\": <function-name>, \"arguments\": <args-json-object>}\n</tool_call><|im_end|>\n" }}
|
| 14 |
+
{%- else %}
|
| 15 |
+
{%- if messages[0]['role'] == 'system' %}
|
| 16 |
+
{{- '<|im_start|>system\n' + messages[0]['content'] + '<|im_end|>\n' }}
|
| 17 |
+
{%- else %}
|
| 18 |
+
{{- '<|im_start|>system\nYou are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>\n' }}
|
| 19 |
+
{%- endif %}
|
| 20 |
+
{%- endif %}
|
| 21 |
+
{%- for message in messages %}
|
| 22 |
+
{%- if (message.role == "user") or (message.role == "system" and not loop.first) or (message.role == "assistant" and not message.tool_calls) %}
|
| 23 |
+
{{- '<|im_start|>' + message.role + '\n' + message.content + '<|im_end|>' + '\n' }}
|
| 24 |
+
{%- elif message.role == "assistant" %}
|
| 25 |
+
{{- '<|im_start|>' + message.role }}
|
| 26 |
+
{%- if message.content %}
|
| 27 |
+
{{- '\n' + message.content }}
|
| 28 |
+
{%- endif %}
|
| 29 |
+
{%- for tool_call in message.tool_calls %}
|
| 30 |
+
{%- if tool_call.function is defined %}
|
| 31 |
+
{%- set tool_call = tool_call.function %}
|
| 32 |
+
{%- endif %}
|
| 33 |
+
{{- '\n<tool_call>\n{"name": "' }}
|
| 34 |
+
{{- tool_call.name }}
|
| 35 |
+
{{- '", "arguments": ' }}
|
| 36 |
+
{{- tool_call.arguments | tojson }}
|
| 37 |
+
{{- '}\n</tool_call>' }}
|
| 38 |
+
{%- endfor %}
|
| 39 |
+
{{- '<|im_end|>\n' }}
|
| 40 |
+
{%- elif message.role == "tool" %}
|
| 41 |
+
{%- if (loop.index0 == 0) or (messages[loop.index0 - 1].role != "tool") %}
|
| 42 |
+
{{- '<|im_start|>user' }}
|
| 43 |
+
{%- endif %}
|
| 44 |
+
{{- '\n<tool_response>\n' }}
|
| 45 |
+
{{- message.content }}
|
| 46 |
+
{{- '\n</tool_response>' }}
|
| 47 |
+
{%- if loop.last or (messages[loop.index0 + 1].role != "tool") %}
|
| 48 |
+
{{- '<|im_end|>\n' }}
|
| 49 |
+
{%- endif %}
|
| 50 |
+
{%- endif %}
|
| 51 |
+
{%- endfor %}
|
| 52 |
+
{%- if add_generation_prompt %}
|
| 53 |
+
{{- '<|im_start|>assistant\n' }}
|
| 54 |
+
{%- endif %}
|
eval_results.json
ADDED
|
@@ -0,0 +1,7 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"epoch": 2.0,
|
| 3 |
+
"eval_loss": 0.9146204590797424,
|
| 4 |
+
"eval_runtime": 247.06,
|
| 5 |
+
"eval_samples_per_second": 121.428,
|
| 6 |
+
"eval_steps_per_second": 7.589
|
| 7 |
+
}
|
merges.txt
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|
special_tokens_map.json
ADDED
|
@@ -0,0 +1,31 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"additional_special_tokens": [
|
| 3 |
+
"<|im_start|>",
|
| 4 |
+
"<|im_end|>",
|
| 5 |
+
"<|object_ref_start|>",
|
| 6 |
+
"<|object_ref_end|>",
|
| 7 |
+
"<|box_start|>",
|
| 8 |
+
"<|box_end|>",
|
| 9 |
+
"<|quad_start|>",
|
| 10 |
+
"<|quad_end|>",
|
| 11 |
+
"<|vision_start|>",
|
| 12 |
+
"<|vision_end|>",
|
| 13 |
+
"<|vision_pad|>",
|
| 14 |
+
"<|image_pad|>",
|
| 15 |
+
"<|video_pad|>"
|
| 16 |
+
],
|
| 17 |
+
"eos_token": {
|
| 18 |
+
"content": "<|im_end|>",
|
| 19 |
+
"lstrip": false,
|
| 20 |
+
"normalized": false,
|
| 21 |
+
"rstrip": false,
|
| 22 |
+
"single_word": false
|
| 23 |
+
},
|
| 24 |
+
"pad_token": {
|
| 25 |
+
"content": "<|endoftext|>",
|
| 26 |
+
"lstrip": false,
|
| 27 |
+
"normalized": false,
|
| 28 |
+
"rstrip": false,
|
| 29 |
+
"single_word": false
|
| 30 |
+
}
|
| 31 |
+
}
|
tokenizer.json
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:9c5ae00e602b8860cbd784ba82a8aa14e8feecec692e7076590d014d7b7fdafa
|
| 3 |
+
size 11421896
|
tokenizer_config.json
ADDED
|
@@ -0,0 +1,208 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"add_bos_token": false,
|
| 3 |
+
"add_prefix_space": false,
|
| 4 |
+
"added_tokens_decoder": {
|
| 5 |
+
"151643": {
|
| 6 |
+
"content": "<|endoftext|>",
|
| 7 |
+
"lstrip": false,
|
| 8 |
+
"normalized": false,
|
| 9 |
+
"rstrip": false,
|
| 10 |
+
"single_word": false,
|
| 11 |
+
"special": true
|
| 12 |
+
},
|
| 13 |
+
"151644": {
|
| 14 |
+
"content": "<|im_start|>",
|
| 15 |
+
"lstrip": false,
|
| 16 |
+
"normalized": false,
|
| 17 |
+
"rstrip": false,
|
| 18 |
+
"single_word": false,
|
| 19 |
+
"special": true
|
| 20 |
+
},
|
| 21 |
+
"151645": {
|
| 22 |
+
"content": "<|im_end|>",
|
| 23 |
+
"lstrip": false,
|
| 24 |
+
"normalized": false,
|
| 25 |
+
"rstrip": false,
|
| 26 |
+
"single_word": false,
|
| 27 |
+
"special": true
|
| 28 |
+
},
|
| 29 |
+
"151646": {
|
| 30 |
+
"content": "<|object_ref_start|>",
|
| 31 |
+
"lstrip": false,
|
| 32 |
+
"normalized": false,
|
| 33 |
+
"rstrip": false,
|
| 34 |
+
"single_word": false,
|
| 35 |
+
"special": true
|
| 36 |
+
},
|
| 37 |
+
"151647": {
|
| 38 |
+
"content": "<|object_ref_end|>",
|
| 39 |
+
"lstrip": false,
|
| 40 |
+
"normalized": false,
|
| 41 |
+
"rstrip": false,
|
| 42 |
+
"single_word": false,
|
| 43 |
+
"special": true
|
| 44 |
+
},
|
| 45 |
+
"151648": {
|
| 46 |
+
"content": "<|box_start|>",
|
| 47 |
+
"lstrip": false,
|
| 48 |
+
"normalized": false,
|
| 49 |
+
"rstrip": false,
|
| 50 |
+
"single_word": false,
|
| 51 |
+
"special": true
|
| 52 |
+
},
|
| 53 |
+
"151649": {
|
| 54 |
+
"content": "<|box_end|>",
|
| 55 |
+
"lstrip": false,
|
| 56 |
+
"normalized": false,
|
| 57 |
+
"rstrip": false,
|
| 58 |
+
"single_word": false,
|
| 59 |
+
"special": true
|
| 60 |
+
},
|
| 61 |
+
"151650": {
|
| 62 |
+
"content": "<|quad_start|>",
|
| 63 |
+
"lstrip": false,
|
| 64 |
+
"normalized": false,
|
| 65 |
+
"rstrip": false,
|
| 66 |
+
"single_word": false,
|
| 67 |
+
"special": true
|
| 68 |
+
},
|
| 69 |
+
"151651": {
|
| 70 |
+
"content": "<|quad_end|>",
|
| 71 |
+
"lstrip": false,
|
| 72 |
+
"normalized": false,
|
| 73 |
+
"rstrip": false,
|
| 74 |
+
"single_word": false,
|
| 75 |
+
"special": true
|
| 76 |
+
},
|
| 77 |
+
"151652": {
|
| 78 |
+
"content": "<|vision_start|>",
|
| 79 |
+
"lstrip": false,
|
| 80 |
+
"normalized": false,
|
| 81 |
+
"rstrip": false,
|
| 82 |
+
"single_word": false,
|
| 83 |
+
"special": true
|
| 84 |
+
},
|
| 85 |
+
"151653": {
|
| 86 |
+
"content": "<|vision_end|>",
|
| 87 |
+
"lstrip": false,
|
| 88 |
+
"normalized": false,
|
| 89 |
+
"rstrip": false,
|
| 90 |
+
"single_word": false,
|
| 91 |
+
"special": true
|
| 92 |
+
},
|
| 93 |
+
"151654": {
|
| 94 |
+
"content": "<|vision_pad|>",
|
| 95 |
+
"lstrip": false,
|
| 96 |
+
"normalized": false,
|
| 97 |
+
"rstrip": false,
|
| 98 |
+
"single_word": false,
|
| 99 |
+
"special": true
|
| 100 |
+
},
|
| 101 |
+
"151655": {
|
| 102 |
+
"content": "<|image_pad|>",
|
| 103 |
+
"lstrip": false,
|
| 104 |
+
"normalized": false,
|
| 105 |
+
"rstrip": false,
|
| 106 |
+
"single_word": false,
|
| 107 |
+
"special": true
|
| 108 |
+
},
|
| 109 |
+
"151656": {
|
| 110 |
+
"content": "<|video_pad|>",
|
| 111 |
+
"lstrip": false,
|
| 112 |
+
"normalized": false,
|
| 113 |
+
"rstrip": false,
|
| 114 |
+
"single_word": false,
|
| 115 |
+
"special": true
|
| 116 |
+
},
|
| 117 |
+
"151657": {
|
| 118 |
+
"content": "<tool_call>",
|
| 119 |
+
"lstrip": false,
|
| 120 |
+
"normalized": false,
|
| 121 |
+
"rstrip": false,
|
| 122 |
+
"single_word": false,
|
| 123 |
+
"special": false
|
| 124 |
+
},
|
| 125 |
+
"151658": {
|
| 126 |
+
"content": "</tool_call>",
|
| 127 |
+
"lstrip": false,
|
| 128 |
+
"normalized": false,
|
| 129 |
+
"rstrip": false,
|
| 130 |
+
"single_word": false,
|
| 131 |
+
"special": false
|
| 132 |
+
},
|
| 133 |
+
"151659": {
|
| 134 |
+
"content": "<|fim_prefix|>",
|
| 135 |
+
"lstrip": false,
|
| 136 |
+
"normalized": false,
|
| 137 |
+
"rstrip": false,
|
| 138 |
+
"single_word": false,
|
| 139 |
+
"special": false
|
| 140 |
+
},
|
| 141 |
+
"151660": {
|
| 142 |
+
"content": "<|fim_middle|>",
|
| 143 |
+
"lstrip": false,
|
| 144 |
+
"normalized": false,
|
| 145 |
+
"rstrip": false,
|
| 146 |
+
"single_word": false,
|
| 147 |
+
"special": false
|
| 148 |
+
},
|
| 149 |
+
"151661": {
|
| 150 |
+
"content": "<|fim_suffix|>",
|
| 151 |
+
"lstrip": false,
|
| 152 |
+
"normalized": false,
|
| 153 |
+
"rstrip": false,
|
| 154 |
+
"single_word": false,
|
| 155 |
+
"special": false
|
| 156 |
+
},
|
| 157 |
+
"151662": {
|
| 158 |
+
"content": "<|fim_pad|>",
|
| 159 |
+
"lstrip": false,
|
| 160 |
+
"normalized": false,
|
| 161 |
+
"rstrip": false,
|
| 162 |
+
"single_word": false,
|
| 163 |
+
"special": false
|
| 164 |
+
},
|
| 165 |
+
"151663": {
|
| 166 |
+
"content": "<|repo_name|>",
|
| 167 |
+
"lstrip": false,
|
| 168 |
+
"normalized": false,
|
| 169 |
+
"rstrip": false,
|
| 170 |
+
"single_word": false,
|
| 171 |
+
"special": false
|
| 172 |
+
},
|
| 173 |
+
"151664": {
|
| 174 |
+
"content": "<|file_sep|>",
|
| 175 |
+
"lstrip": false,
|
| 176 |
+
"normalized": false,
|
| 177 |
+
"rstrip": false,
|
| 178 |
+
"single_word": false,
|
| 179 |
+
"special": false
|
| 180 |
+
}
|
| 181 |
+
},
|
| 182 |
+
"additional_special_tokens": [
|
| 183 |
+
"<|im_start|>",
|
| 184 |
+
"<|im_end|>",
|
| 185 |
+
"<|object_ref_start|>",
|
| 186 |
+
"<|object_ref_end|>",
|
| 187 |
+
"<|box_start|>",
|
| 188 |
+
"<|box_end|>",
|
| 189 |
+
"<|quad_start|>",
|
| 190 |
+
"<|quad_end|>",
|
| 191 |
+
"<|vision_start|>",
|
| 192 |
+
"<|vision_end|>",
|
| 193 |
+
"<|vision_pad|>",
|
| 194 |
+
"<|image_pad|>",
|
| 195 |
+
"<|video_pad|>"
|
| 196 |
+
],
|
| 197 |
+
"bos_token": null,
|
| 198 |
+
"clean_up_tokenization_spaces": false,
|
| 199 |
+
"eos_token": "<|im_end|>",
|
| 200 |
+
"errors": "replace",
|
| 201 |
+
"extra_special_tokens": {},
|
| 202 |
+
"model_max_length": 32768,
|
| 203 |
+
"pad_token": "<|endoftext|>",
|
| 204 |
+
"padding_side": "right",
|
| 205 |
+
"split_special_tokens": false,
|
| 206 |
+
"tokenizer_class": "Qwen2Tokenizer",
|
| 207 |
+
"unk_token": null
|
| 208 |
+
}
|
train_results.json
ADDED
|
@@ -0,0 +1,8 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"epoch": 2.0,
|
| 3 |
+
"total_flos": 1.2106519982783857e+19,
|
| 4 |
+
"train_loss": 0.9370549143886313,
|
| 5 |
+
"train_runtime": 28045.4399,
|
| 6 |
+
"train_samples_per_second": 41.361,
|
| 7 |
+
"train_steps_per_second": 0.323
|
| 8 |
+
}
|
trainer_log.jsonl
ADDED
|
@@ -0,0 +1,14 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{"current_steps": 800, "total_steps": 9064, "loss": 1.2362, "lr": 8.809261300992283e-05, "epoch": 0.17655172413793102, "percentage": 8.83, "elapsed_time": "0:40:10", "remaining_time": "6:54:58"}
|
| 2 |
+
{"current_steps": 1600, "total_steps": 9064, "loss": 0.9159, "lr": 9.823469895169365e-05, "epoch": 0.35310344827586204, "percentage": 17.65, "elapsed_time": "1:20:49", "remaining_time": "6:17:05"}
|
| 3 |
+
{"current_steps": 2400, "total_steps": 9064, "loss": 0.9125, "lr": 9.19696754273079e-05, "epoch": 0.5296551724137931, "percentage": 26.48, "elapsed_time": "2:01:31", "remaining_time": "5:37:25"}
|
| 4 |
+
{"current_steps": 3200, "total_steps": 9064, "loss": 0.9134, "lr": 8.175175096510351e-05, "epoch": 0.7062068965517241, "percentage": 35.3, "elapsed_time": "2:41:49", "remaining_time": "4:56:32"}
|
| 5 |
+
{"current_steps": 4000, "total_steps": 9064, "loss": 0.9108, "lr": 6.854329762962416e-05, "epoch": 0.8827586206896552, "percentage": 44.13, "elapsed_time": "3:22:08", "remaining_time": "4:15:54"}
|
| 6 |
+
{"current_steps": 4000, "total_steps": 9064, "eval_loss": 0.9154898524284363, "epoch": 0.8827586206896552, "percentage": 44.13, "elapsed_time": "3:26:15", "remaining_time": "4:21:07"}
|
| 7 |
+
{"current_steps": 4800, "total_steps": 9064, "loss": 0.9084, "lr": 5.358834952514551e-05, "epoch": 1.059144827586207, "percentage": 52.96, "elapsed_time": "4:07:28", "remaining_time": "3:39:50"}
|
| 8 |
+
{"current_steps": 5600, "total_steps": 9064, "loss": 0.9046, "lr": 3.8295433827190085e-05, "epoch": 1.2356965517241378, "percentage": 61.78, "elapsed_time": "4:47:53", "remaining_time": "2:58:05"}
|
| 9 |
+
{"current_steps": 6400, "total_steps": 9064, "loss": 0.9043, "lr": 2.4104909084852035e-05, "epoch": 1.412248275862069, "percentage": 70.61, "elapsed_time": "5:28:10", "remaining_time": "2:16:36"}
|
| 10 |
+
{"current_steps": 7200, "total_steps": 9064, "loss": 0.9047, "lr": 1.2353305495017958e-05, "epoch": 1.5888, "percentage": 79.44, "elapsed_time": "6:08:58", "remaining_time": "1:35:31"}
|
| 11 |
+
{"current_steps": 8000, "total_steps": 9064, "loss": 0.904, "lr": 4.147444217922592e-06, "epoch": 1.765351724137931, "percentage": 88.26, "elapsed_time": "6:49:27", "remaining_time": "0:54:27"}
|
| 12 |
+
{"current_steps": 8000, "total_steps": 9064, "eval_loss": 0.9144690036773682, "epoch": 1.765351724137931, "percentage": 88.26, "elapsed_time": "6:53:34", "remaining_time": "0:55:00"}
|
| 13 |
+
{"current_steps": 8800, "total_steps": 9064, "loss": 0.9044, "lr": 2.6019176748554587e-07, "epoch": 1.9419034482758621, "percentage": 97.09, "elapsed_time": "7:34:00", "remaining_time": "0:13:37"}
|
| 14 |
+
{"current_steps": 9064, "total_steps": 9064, "epoch": 2.0, "percentage": 100.0, "elapsed_time": "7:47:24", "remaining_time": "0:00:00"}
|
trainer_state.json
ADDED
|
@@ -0,0 +1,136 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"best_global_step": null,
|
| 3 |
+
"best_metric": null,
|
| 4 |
+
"best_model_checkpoint": null,
|
| 5 |
+
"epoch": 2.0,
|
| 6 |
+
"eval_steps": 4000,
|
| 7 |
+
"global_step": 9064,
|
| 8 |
+
"is_hyper_param_search": false,
|
| 9 |
+
"is_local_process_zero": true,
|
| 10 |
+
"is_world_process_zero": true,
|
| 11 |
+
"log_history": [
|
| 12 |
+
{
|
| 13 |
+
"epoch": 0.17655172413793102,
|
| 14 |
+
"grad_norm": 0.11938353627920151,
|
| 15 |
+
"learning_rate": 8.809261300992283e-05,
|
| 16 |
+
"loss": 1.2362,
|
| 17 |
+
"step": 800
|
| 18 |
+
},
|
| 19 |
+
{
|
| 20 |
+
"epoch": 0.35310344827586204,
|
| 21 |
+
"grad_norm": 0.148575097322464,
|
| 22 |
+
"learning_rate": 9.823469895169365e-05,
|
| 23 |
+
"loss": 0.9159,
|
| 24 |
+
"step": 1600
|
| 25 |
+
},
|
| 26 |
+
{
|
| 27 |
+
"epoch": 0.5296551724137931,
|
| 28 |
+
"grad_norm": 0.21376433968544006,
|
| 29 |
+
"learning_rate": 9.19696754273079e-05,
|
| 30 |
+
"loss": 0.9125,
|
| 31 |
+
"step": 2400
|
| 32 |
+
},
|
| 33 |
+
{
|
| 34 |
+
"epoch": 0.7062068965517241,
|
| 35 |
+
"grad_norm": 0.09860826283693314,
|
| 36 |
+
"learning_rate": 8.175175096510351e-05,
|
| 37 |
+
"loss": 0.9134,
|
| 38 |
+
"step": 3200
|
| 39 |
+
},
|
| 40 |
+
{
|
| 41 |
+
"epoch": 0.8827586206896552,
|
| 42 |
+
"grad_norm": 0.11440066993236542,
|
| 43 |
+
"learning_rate": 6.854329762962416e-05,
|
| 44 |
+
"loss": 0.9108,
|
| 45 |
+
"step": 4000
|
| 46 |
+
},
|
| 47 |
+
{
|
| 48 |
+
"epoch": 0.8827586206896552,
|
| 49 |
+
"eval_loss": 0.9154898524284363,
|
| 50 |
+
"eval_runtime": 247.4123,
|
| 51 |
+
"eval_samples_per_second": 121.255,
|
| 52 |
+
"eval_steps_per_second": 7.578,
|
| 53 |
+
"step": 4000
|
| 54 |
+
},
|
| 55 |
+
{
|
| 56 |
+
"epoch": 1.059144827586207,
|
| 57 |
+
"grad_norm": 0.10314279049634933,
|
| 58 |
+
"learning_rate": 5.358834952514551e-05,
|
| 59 |
+
"loss": 0.9084,
|
| 60 |
+
"step": 4800
|
| 61 |
+
},
|
| 62 |
+
{
|
| 63 |
+
"epoch": 1.2356965517241378,
|
| 64 |
+
"grad_norm": 0.15208840370178223,
|
| 65 |
+
"learning_rate": 3.8295433827190085e-05,
|
| 66 |
+
"loss": 0.9046,
|
| 67 |
+
"step": 5600
|
| 68 |
+
},
|
| 69 |
+
{
|
| 70 |
+
"epoch": 1.412248275862069,
|
| 71 |
+
"grad_norm": 0.10573920607566833,
|
| 72 |
+
"learning_rate": 2.4104909084852035e-05,
|
| 73 |
+
"loss": 0.9043,
|
| 74 |
+
"step": 6400
|
| 75 |
+
},
|
| 76 |
+
{
|
| 77 |
+
"epoch": 1.5888,
|
| 78 |
+
"grad_norm": 0.2402600795030594,
|
| 79 |
+
"learning_rate": 1.2353305495017958e-05,
|
| 80 |
+
"loss": 0.9047,
|
| 81 |
+
"step": 7200
|
| 82 |
+
},
|
| 83 |
+
{
|
| 84 |
+
"epoch": 1.765351724137931,
|
| 85 |
+
"grad_norm": 0.10216963291168213,
|
| 86 |
+
"learning_rate": 4.147444217922592e-06,
|
| 87 |
+
"loss": 0.904,
|
| 88 |
+
"step": 8000
|
| 89 |
+
},
|
| 90 |
+
{
|
| 91 |
+
"epoch": 1.765351724137931,
|
| 92 |
+
"eval_loss": 0.9144690036773682,
|
| 93 |
+
"eval_runtime": 247.1254,
|
| 94 |
+
"eval_samples_per_second": 121.396,
|
| 95 |
+
"eval_steps_per_second": 7.587,
|
| 96 |
+
"step": 8000
|
| 97 |
+
},
|
| 98 |
+
{
|
| 99 |
+
"epoch": 1.9419034482758621,
|
| 100 |
+
"grad_norm": 0.17538346350193024,
|
| 101 |
+
"learning_rate": 2.6019176748554587e-07,
|
| 102 |
+
"loss": 0.9044,
|
| 103 |
+
"step": 8800
|
| 104 |
+
},
|
| 105 |
+
{
|
| 106 |
+
"epoch": 2.0,
|
| 107 |
+
"step": 9064,
|
| 108 |
+
"total_flos": 1.2106519982783857e+19,
|
| 109 |
+
"train_loss": 0.9370549143886313,
|
| 110 |
+
"train_runtime": 28045.4399,
|
| 111 |
+
"train_samples_per_second": 41.361,
|
| 112 |
+
"train_steps_per_second": 0.323
|
| 113 |
+
}
|
| 114 |
+
],
|
| 115 |
+
"logging_steps": 800,
|
| 116 |
+
"max_steps": 9064,
|
| 117 |
+
"num_input_tokens_seen": 0,
|
| 118 |
+
"num_train_epochs": 2,
|
| 119 |
+
"save_steps": 4000,
|
| 120 |
+
"stateful_callbacks": {
|
| 121 |
+
"TrainerControl": {
|
| 122 |
+
"args": {
|
| 123 |
+
"should_epoch_stop": false,
|
| 124 |
+
"should_evaluate": false,
|
| 125 |
+
"should_log": false,
|
| 126 |
+
"should_save": true,
|
| 127 |
+
"should_training_stop": true
|
| 128 |
+
},
|
| 129 |
+
"attributes": {}
|
| 130 |
+
}
|
| 131 |
+
},
|
| 132 |
+
"total_flos": 1.2106519982783857e+19,
|
| 133 |
+
"train_batch_size": 4,
|
| 134 |
+
"trial_name": null,
|
| 135 |
+
"trial_params": null
|
| 136 |
+
}
|
training_args.bin
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:a13b2aa364c3d808469a6e54c1dc7bdb748951588e2d452e41a0844ab80023c5
|
| 3 |
+
size 6161
|
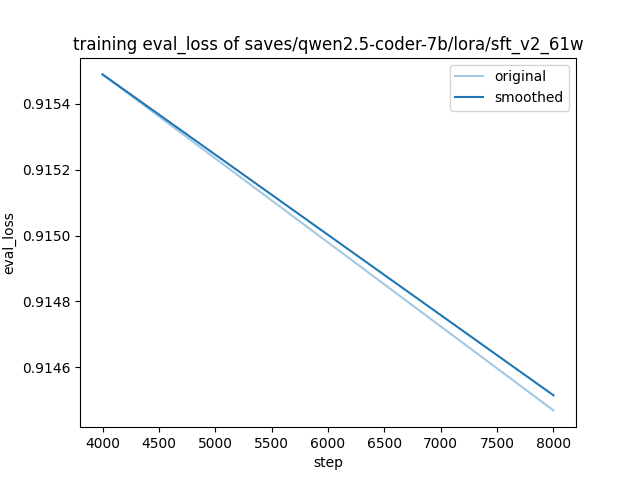
training_eval_loss.png
ADDED
|
training_loss.png
ADDED

|
vocab.json
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|