

End of training
Browse files- README.md +3 -2
- all_results.json +12 -0
- eval_results.json +7 -0
- train_results.json +8 -0
- trainer_state.json +215 -0
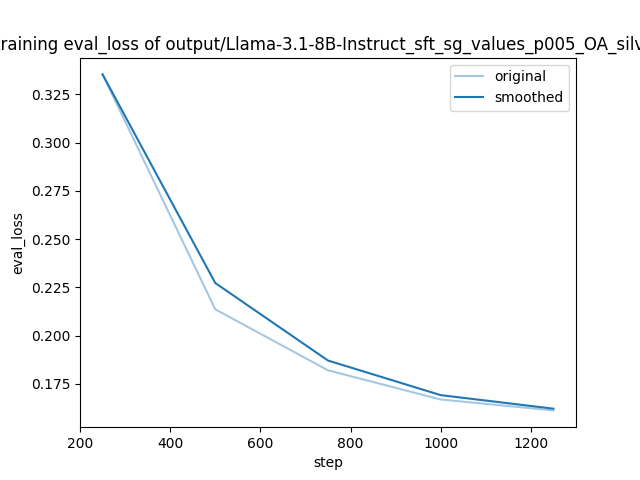
- training_eval_loss.png +0 -0
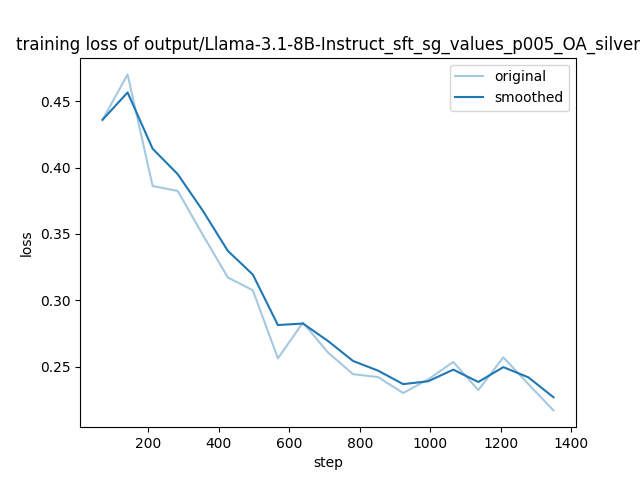
- training_loss.png +0 -0
README.md
CHANGED
|
@@ -4,6 +4,7 @@ license: llama3.1
|
|
| 4 |
base_model: meta-llama/Llama-3.1-8B-Instruct
|
| 5 |
tags:
|
| 6 |
- llama-factory
|
|
|
|
| 7 |
- generated_from_trainer
|
| 8 |
model-index:
|
| 9 |
- name: Llama-3.1-8B-Instruct_sft_sg_values_p005_OA_silver
|
|
@@ -15,9 +16,9 @@ should probably proofread and complete it, then remove this comment. -->
|
|
| 15 |
|
| 16 |
# Llama-3.1-8B-Instruct_sft_sg_values_p005_OA_silver
|
| 17 |
|
| 18 |
-
This model is a fine-tuned version of [meta-llama/Llama-3.1-8B-Instruct](https://huggingface.co/meta-llama/Llama-3.1-8B-Instruct) on
|
| 19 |
It achieves the following results on the evaluation set:
|
| 20 |
-
- Loss: 0.
|
| 21 |
|
| 22 |
## Model description
|
| 23 |
|
|
|
|
| 4 |
base_model: meta-llama/Llama-3.1-8B-Instruct
|
| 5 |
tags:
|
| 6 |
- llama-factory
|
| 7 |
+
- lora
|
| 8 |
- generated_from_trainer
|
| 9 |
model-index:
|
| 10 |
- name: Llama-3.1-8B-Instruct_sft_sg_values_p005_OA_silver
|
|
|
|
| 16 |
|
| 17 |
# Llama-3.1-8B-Instruct_sft_sg_values_p005_OA_silver
|
| 18 |
|
| 19 |
+
This model is a fine-tuned version of [meta-llama/Llama-3.1-8B-Instruct](https://huggingface.co/meta-llama/Llama-3.1-8B-Instruct) on the sft_sg_values_p005_OA_silver dataset.
|
| 20 |
It achieves the following results on the evaluation set:
|
| 21 |
+
- Loss: 0.1600
|
| 22 |
|
| 23 |
## Model description
|
| 24 |
|
all_results.json
ADDED
|
@@ -0,0 +1,12 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"epoch": 0.9996440014239943,
|
| 3 |
+
"eval_loss": 0.1599513590335846,
|
| 4 |
+
"eval_runtime": 28.6358,
|
| 5 |
+
"eval_samples_per_second": 17.461,
|
| 6 |
+
"eval_steps_per_second": 8.73,
|
| 7 |
+
"total_flos": 1.0823852276239565e+17,
|
| 8 |
+
"train_loss": 0.2917507768016935,
|
| 9 |
+
"train_runtime": 2474.252,
|
| 10 |
+
"train_samples_per_second": 4.541,
|
| 11 |
+
"train_steps_per_second": 0.567
|
| 12 |
+
}
|
eval_results.json
ADDED
|
@@ -0,0 +1,7 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"epoch": 0.9996440014239943,
|
| 3 |
+
"eval_loss": 0.1599513590335846,
|
| 4 |
+
"eval_runtime": 28.6358,
|
| 5 |
+
"eval_samples_per_second": 17.461,
|
| 6 |
+
"eval_steps_per_second": 8.73
|
| 7 |
+
}
|
train_results.json
ADDED
|
@@ -0,0 +1,8 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"epoch": 0.9996440014239943,
|
| 3 |
+
"total_flos": 1.0823852276239565e+17,
|
| 4 |
+
"train_loss": 0.2917507768016935,
|
| 5 |
+
"train_runtime": 2474.252,
|
| 6 |
+
"train_samples_per_second": 4.541,
|
| 7 |
+
"train_steps_per_second": 0.567
|
| 8 |
+
}
|
trainer_state.json
ADDED
|
@@ -0,0 +1,215 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"best_metric": null,
|
| 3 |
+
"best_model_checkpoint": null,
|
| 4 |
+
"epoch": 0.9996440014239943,
|
| 5 |
+
"eval_steps": 250,
|
| 6 |
+
"global_step": 1404,
|
| 7 |
+
"is_hyper_param_search": false,
|
| 8 |
+
"is_local_process_zero": true,
|
| 9 |
+
"is_world_process_zero": true,
|
| 10 |
+
"log_history": [
|
| 11 |
+
{
|
| 12 |
+
"epoch": 0.05055179779280883,
|
| 13 |
+
"grad_norm": 0.6696942448616028,
|
| 14 |
+
"learning_rate": 5.0354609929078e-07,
|
| 15 |
+
"loss": 0.436,
|
| 16 |
+
"step": 71
|
| 17 |
+
},
|
| 18 |
+
{
|
| 19 |
+
"epoch": 0.10110359558561766,
|
| 20 |
+
"grad_norm": 1.0538969039916992,
|
| 21 |
+
"learning_rate": 9.992082343626285e-07,
|
| 22 |
+
"loss": 0.4702,
|
| 23 |
+
"step": 142
|
| 24 |
+
},
|
| 25 |
+
{
|
| 26 |
+
"epoch": 0.15165539337842648,
|
| 27 |
+
"grad_norm": 4.0300822257995605,
|
| 28 |
+
"learning_rate": 9.429928741092636e-07,
|
| 29 |
+
"loss": 0.3861,
|
| 30 |
+
"step": 213
|
| 31 |
+
},
|
| 32 |
+
{
|
| 33 |
+
"epoch": 0.17799928800284798,
|
| 34 |
+
"eval_loss": 0.33530548214912415,
|
| 35 |
+
"eval_runtime": 28.7859,
|
| 36 |
+
"eval_samples_per_second": 17.37,
|
| 37 |
+
"eval_steps_per_second": 8.685,
|
| 38 |
+
"step": 250
|
| 39 |
+
},
|
| 40 |
+
{
|
| 41 |
+
"epoch": 0.2022071911712353,
|
| 42 |
+
"grad_norm": 1.1703342199325562,
|
| 43 |
+
"learning_rate": 8.867775138558986e-07,
|
| 44 |
+
"loss": 0.3824,
|
| 45 |
+
"step": 284
|
| 46 |
+
},
|
| 47 |
+
{
|
| 48 |
+
"epoch": 0.25275898896404414,
|
| 49 |
+
"grad_norm": 1.0430041551589966,
|
| 50 |
+
"learning_rate": 8.305621536025336e-07,
|
| 51 |
+
"loss": 0.3494,
|
| 52 |
+
"step": 355
|
| 53 |
+
},
|
| 54 |
+
{
|
| 55 |
+
"epoch": 0.30331078675685297,
|
| 56 |
+
"grad_norm": 1.1387194395065308,
|
| 57 |
+
"learning_rate": 7.743467933491686e-07,
|
| 58 |
+
"loss": 0.3172,
|
| 59 |
+
"step": 426
|
| 60 |
+
},
|
| 61 |
+
{
|
| 62 |
+
"epoch": 0.3538625845496618,
|
| 63 |
+
"grad_norm": 1.7634204626083374,
|
| 64 |
+
"learning_rate": 7.181314330958036e-07,
|
| 65 |
+
"loss": 0.3075,
|
| 66 |
+
"step": 497
|
| 67 |
+
},
|
| 68 |
+
{
|
| 69 |
+
"epoch": 0.35599857600569595,
|
| 70 |
+
"eval_loss": 0.21360304951667786,
|
| 71 |
+
"eval_runtime": 28.7874,
|
| 72 |
+
"eval_samples_per_second": 17.369,
|
| 73 |
+
"eval_steps_per_second": 8.684,
|
| 74 |
+
"step": 500
|
| 75 |
+
},
|
| 76 |
+
{
|
| 77 |
+
"epoch": 0.4044143823424706,
|
| 78 |
+
"grad_norm": 2.539411783218384,
|
| 79 |
+
"learning_rate": 6.619160728424386e-07,
|
| 80 |
+
"loss": 0.2562,
|
| 81 |
+
"step": 568
|
| 82 |
+
},
|
| 83 |
+
{
|
| 84 |
+
"epoch": 0.45496618013527945,
|
| 85 |
+
"grad_norm": 1.2169667482376099,
|
| 86 |
+
"learning_rate": 6.057007125890736e-07,
|
| 87 |
+
"loss": 0.2832,
|
| 88 |
+
"step": 639
|
| 89 |
+
},
|
| 90 |
+
{
|
| 91 |
+
"epoch": 0.5055179779280883,
|
| 92 |
+
"grad_norm": 1.549967646598816,
|
| 93 |
+
"learning_rate": 5.494853523357086e-07,
|
| 94 |
+
"loss": 0.2606,
|
| 95 |
+
"step": 710
|
| 96 |
+
},
|
| 97 |
+
{
|
| 98 |
+
"epoch": 0.533997864008544,
|
| 99 |
+
"eval_loss": 0.1820104718208313,
|
| 100 |
+
"eval_runtime": 28.7804,
|
| 101 |
+
"eval_samples_per_second": 17.373,
|
| 102 |
+
"eval_steps_per_second": 8.686,
|
| 103 |
+
"step": 750
|
| 104 |
+
},
|
| 105 |
+
{
|
| 106 |
+
"epoch": 0.5560697757208971,
|
| 107 |
+
"grad_norm": 1.2805540561676025,
|
| 108 |
+
"learning_rate": 4.932699920823436e-07,
|
| 109 |
+
"loss": 0.2443,
|
| 110 |
+
"step": 781
|
| 111 |
+
},
|
| 112 |
+
{
|
| 113 |
+
"epoch": 0.6066215735137059,
|
| 114 |
+
"grad_norm": 2.841620683670044,
|
| 115 |
+
"learning_rate": 4.3705463182897863e-07,
|
| 116 |
+
"loss": 0.2421,
|
| 117 |
+
"step": 852
|
| 118 |
+
},
|
| 119 |
+
{
|
| 120 |
+
"epoch": 0.6571733713065148,
|
| 121 |
+
"grad_norm": 1.1338871717453003,
|
| 122 |
+
"learning_rate": 3.808392715756136e-07,
|
| 123 |
+
"loss": 0.2301,
|
| 124 |
+
"step": 923
|
| 125 |
+
},
|
| 126 |
+
{
|
| 127 |
+
"epoch": 0.7077251690993236,
|
| 128 |
+
"grad_norm": 2.319748878479004,
|
| 129 |
+
"learning_rate": 3.246239113222486e-07,
|
| 130 |
+
"loss": 0.2404,
|
| 131 |
+
"step": 994
|
| 132 |
+
},
|
| 133 |
+
{
|
| 134 |
+
"epoch": 0.7119971520113919,
|
| 135 |
+
"eval_loss": 0.16689015924930573,
|
| 136 |
+
"eval_runtime": 28.7832,
|
| 137 |
+
"eval_samples_per_second": 17.371,
|
| 138 |
+
"eval_steps_per_second": 8.686,
|
| 139 |
+
"step": 1000
|
| 140 |
+
},
|
| 141 |
+
{
|
| 142 |
+
"epoch": 0.7582769668921324,
|
| 143 |
+
"grad_norm": 1.218746542930603,
|
| 144 |
+
"learning_rate": 2.684085510688836e-07,
|
| 145 |
+
"loss": 0.2535,
|
| 146 |
+
"step": 1065
|
| 147 |
+
},
|
| 148 |
+
{
|
| 149 |
+
"epoch": 0.8088287646849412,
|
| 150 |
+
"grad_norm": 3.11279296875,
|
| 151 |
+
"learning_rate": 2.1219319081551858e-07,
|
| 152 |
+
"loss": 0.2323,
|
| 153 |
+
"step": 1136
|
| 154 |
+
},
|
| 155 |
+
{
|
| 156 |
+
"epoch": 0.8593805624777501,
|
| 157 |
+
"grad_norm": 2.013932704925537,
|
| 158 |
+
"learning_rate": 1.559778305621536e-07,
|
| 159 |
+
"loss": 0.257,
|
| 160 |
+
"step": 1207
|
| 161 |
+
},
|
| 162 |
+
{
|
| 163 |
+
"epoch": 0.8899964400142399,
|
| 164 |
+
"eval_loss": 0.16124244034290314,
|
| 165 |
+
"eval_runtime": 28.7354,
|
| 166 |
+
"eval_samples_per_second": 17.4,
|
| 167 |
+
"eval_steps_per_second": 8.7,
|
| 168 |
+
"step": 1250
|
| 169 |
+
},
|
| 170 |
+
{
|
| 171 |
+
"epoch": 0.9099323602705589,
|
| 172 |
+
"grad_norm": 1.400206446647644,
|
| 173 |
+
"learning_rate": 9.976247030878859e-08,
|
| 174 |
+
"loss": 0.2368,
|
| 175 |
+
"step": 1278
|
| 176 |
+
},
|
| 177 |
+
{
|
| 178 |
+
"epoch": 0.9604841580633677,
|
| 179 |
+
"grad_norm": 3.216315984725952,
|
| 180 |
+
"learning_rate": 4.35471100554236e-08,
|
| 181 |
+
"loss": 0.217,
|
| 182 |
+
"step": 1349
|
| 183 |
+
},
|
| 184 |
+
{
|
| 185 |
+
"epoch": 0.9996440014239943,
|
| 186 |
+
"step": 1404,
|
| 187 |
+
"total_flos": 1.0823852276239565e+17,
|
| 188 |
+
"train_loss": 0.2917507768016935,
|
| 189 |
+
"train_runtime": 2474.252,
|
| 190 |
+
"train_samples_per_second": 4.541,
|
| 191 |
+
"train_steps_per_second": 0.567
|
| 192 |
+
}
|
| 193 |
+
],
|
| 194 |
+
"logging_steps": 71,
|
| 195 |
+
"max_steps": 1404,
|
| 196 |
+
"num_input_tokens_seen": 0,
|
| 197 |
+
"num_train_epochs": 1,
|
| 198 |
+
"save_steps": 500,
|
| 199 |
+
"stateful_callbacks": {
|
| 200 |
+
"TrainerControl": {
|
| 201 |
+
"args": {
|
| 202 |
+
"should_epoch_stop": false,
|
| 203 |
+
"should_evaluate": false,
|
| 204 |
+
"should_log": false,
|
| 205 |
+
"should_save": true,
|
| 206 |
+
"should_training_stop": true
|
| 207 |
+
},
|
| 208 |
+
"attributes": {}
|
| 209 |
+
}
|
| 210 |
+
},
|
| 211 |
+
"total_flos": 1.0823852276239565e+17,
|
| 212 |
+
"train_batch_size": 2,
|
| 213 |
+
"trial_name": null,
|
| 214 |
+
"trial_params": null
|
| 215 |
+
}
|
training_eval_loss.png
ADDED
|
training_loss.png
ADDED
|