中文 | English
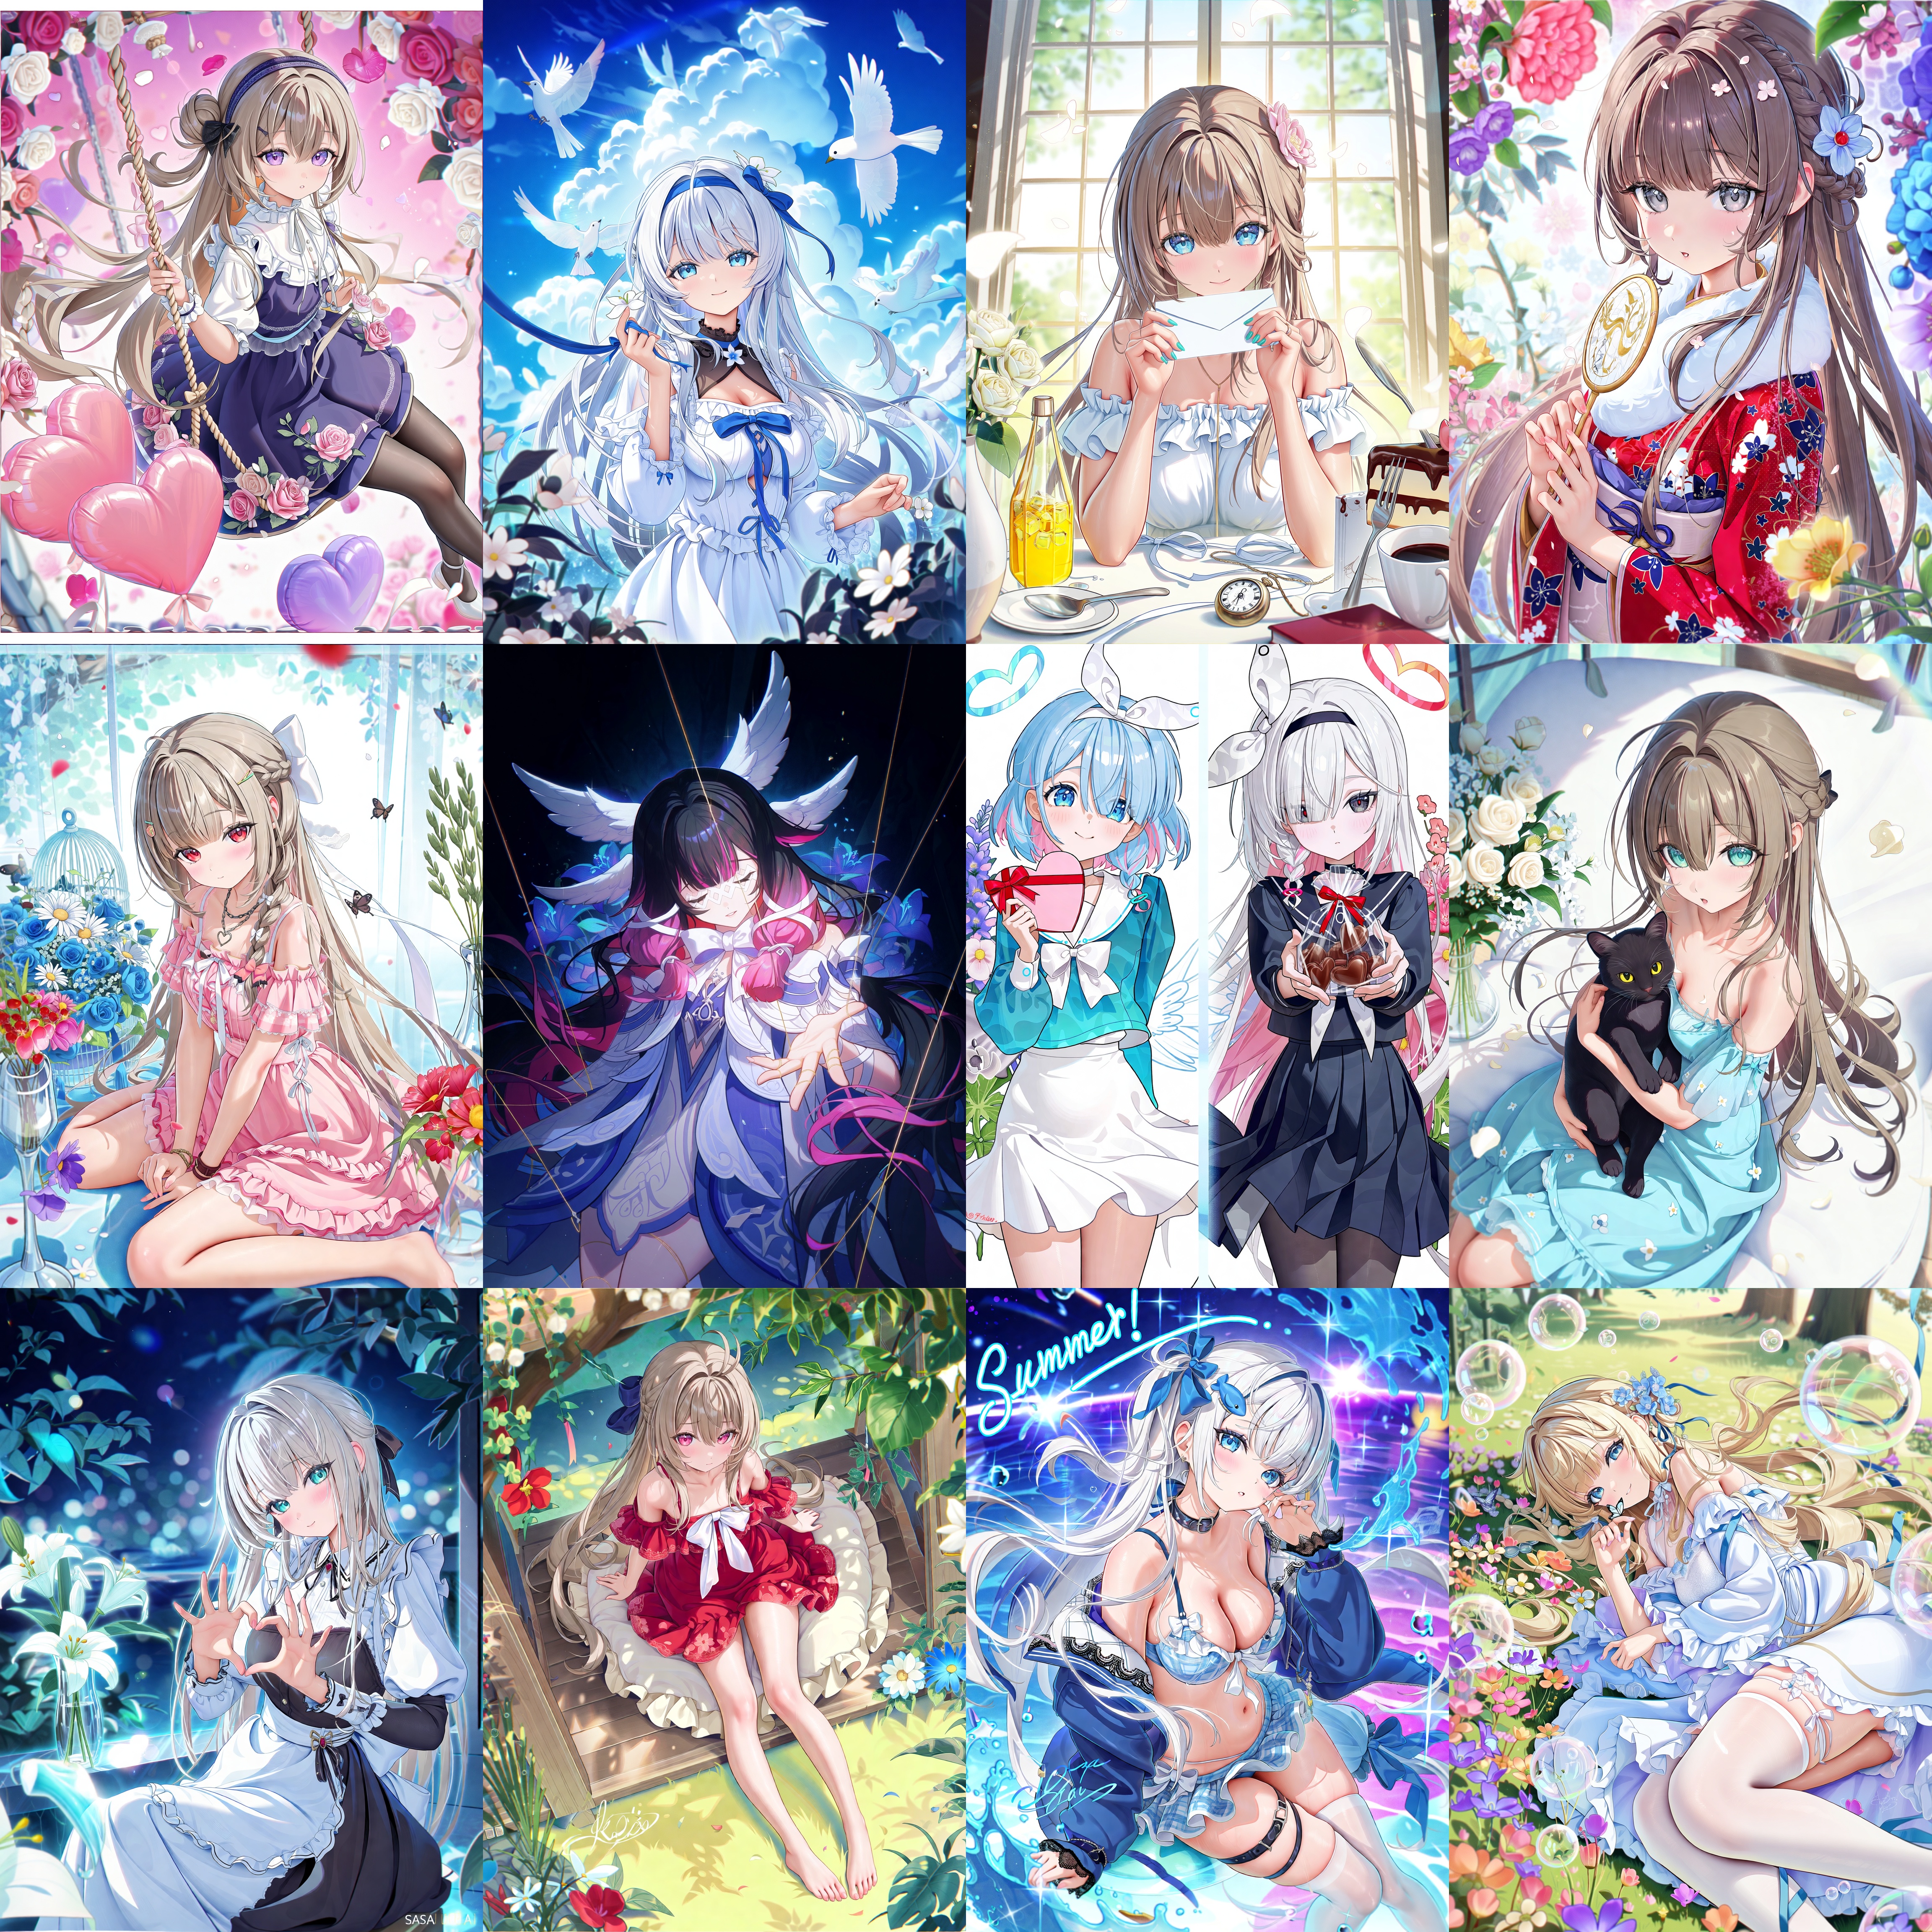
> **TL;DR**:重点提升对 512 token 量级自然语言描述的理解能力;默认以长自然语言描述作提示词(`image_description` 字段)。**建议按下文「快速开始」引导,用 comfyui-zako-pe 组装结构化 caption**;不想写长描述时,也可只给 tag,由 [zako-pe](https://huggingface.co/Johnny-Z/zako-pe) 扩写。 ## 📌 概览 Anima-Light-Lavender 是以 [circlestone-labs/Anima](https://huggingface.co/circlestone-labs/Anima) 系列中的 **Anima-Base v1.0**(`anima-base-v1.0.safetensors`)为基座、经后训练(post-training)得到的版本。与基座模型相比,本版本的重点是**提升模型对 512 token 量级自然语言描述的理解能力**,并借助质量更高的训练数据改善整体生成效果。 本版本**未对架构做任何改动**:层数、参数量与文件布局均与基座一致,可直接替换上游权重并接入现有工作流。 | 项目 | 说明 | | :--- | :--- | | 基座模型 | [circlestone-labs/Anima](https://huggingface.co/circlestone-labs/Anima) 系列的 Anima-Base v1.0(`anima-base-v1.0.safetensors`),构建于 [nvidia/Cosmos-Predict2-2B-Text2Image](https://huggingface.co/nvidia/Cosmos-Predict2-2B-Text2Image) | | 参数量 / 架构 | 与基座完全一致(约 2B 参数、28 层 DiT),无扩层、无蒸馏 | | 任务类型 | text-to-image:二次元插画、角色与风格化艺术图 | | 文本编码器 | Qwen3-0.6B(`qwen_3_06b_base.safetensors`) | | VAE | Qwen-Image VAE(`qwen_image_vae.safetensors`) | | 权重文件 | `anima-light-lavender.safetensors`(单文件,BF16);另有 MXFP8 版 `anima-light-lavender_mxfp8.safetensors`(单文件,可加速推理) | | 训练数据 | 约 170 万张经内部数据管线标注与筛选的 Danbooru 图像;**管线中用于标注、筛选、偏好判别等环节的全部模型均由作者独立完成训练** | | 训练数据截止时间 | 2025 年 11 月底 | | 许可证 | CircleStone Labs Non-Commercial License | ## 🎯 适用场景 **适合 ✅** - **二次元插画与角色图**:希望生成具有特定画风、构图、光影与氛围的图像。 - **自然语言驱动**:希望以一段描述性文字(而非堆砌 tag)精确控制画面。 - **替换升级**:已部署 Anima 工作流的用户,可直接更换 checkpoint 以提升生成质量。 **不适合 ⛔** - **照片写实**:写实摄影风格并非该系列的目标,效果有限。 - **长文本渲染**:难以精确还原招牌、字幕及多行长句中的文字。 ## 🚀 快速开始(ComfyUI) Anima 系列在 ComfyUI 中已获得**原生支持**,本版本可直接替换上游权重。 ### 1. 放置模型文件 | 文件 | 目标目录 | | :--- | :--- | | `anima-light-lavender.safetensors` | `ComfyUI/models/diffusion_models` | | `anima-light-lavender_mxfp8.safetensors` | `ComfyUI/models/diffusion_models` | | `qwen_3_06b_base.safetensors` | `ComfyUI/models/text_encoders` | | `qwen_image_vae.safetensors` | `ComfyUI/models/vae` | 权重提供 **BF16** 与 **MXFP8** 两个版本,**任选其一**放入 `diffusion_models` 即可;MXFP8 版可加速推理。 (后两个文件即上游 Anima 所使用的 Qwen3-0.6B 文本编码器与 Qwen-Image VAE;若你已在运行 Anima 工作流,可直接复用。) ### 2. 安装自定义节点 安装 [comfyui-zako-pe](https://github.com/aa0525/comfyui-zako-pe) 自定义节点,把仓库克隆到 `ComfyUI/custom_nodes/` 后重启 ComfyUI 即可: ```bash cd ComfyUI/custom_nodes git clone https://github.com/aa0525/comfyui-zako-pe.git ``` 没有 git 环境时,也可在仓库页面点击 **Code → Download ZIP**,解压后放入 `ComfyUI/custom_nodes/`,重启 ComfyUI 后生效。 节点包含 `Danbooru Caption JSON` 与 `Danbooru Prompt Extend (OpenAI)`:前者组装结构化 caption,后者调用 OpenAI 兼容服务把 tag 形式的 `image_description` 扩写为自然语言。扩写服务推荐使用配套模型 [zako-pe](https://huggingface.co/Johnny-Z/zako-pe)(ZAKO-V0.1):在 LM Studio 中加载其 GGUF 权重并启动本地服务器(默认地址 `http://127.0.0.1:1234`)即可使用;模型下载与详细用法见其模型卡。 ### 3. 载入工作流 本模型仓库附带两个工作流文件,**拖入 ComfyUI 画布**即可载入,无需手动连线: | 工作流文件 | 说明 | | :--- | :--- | | `anima.json` | 基础工作流:把组装好的结构化 caption 直接送进正向提示词编码,`image_description` 自行写成长自然语言描述 | | `anima-pe.json` | 在基础工作流之上增加 `Danbooru Prompt Extend (OpenAI)` 节点:`image_description` 只写 tag,由扩写服务自动改写为自然语言 | 两个工作流默认加载 MXFP8 权重(`anima-light-lavender_mxfp8.safetensors`);若只下载了 BF16 版,在 **Load Diffusion Model** 节点中改选 `anima-light-lavender.safetensors` 即可。 ### 4. 生成参数(推荐) | 参数 | 推荐值 | | :--- | :--- | | Sampler | `euler` | | Scheduler | `simple` | | Steps | 25 | | CFG | 4.0 | | 分辨率 | 约 1280×1280 像素 | | 负向提示词 | **留空** | ## ✍️ 提示词(Prompting) ### 结构化 Caption 本版本基于结构化 caption 训练,因此能够理解字段顺序固定的文本块: ```text { "year": 2025, "preference_level": "best", "artist": [...], "copyright": [...], "character": [...], "image_description": "...", "extra_tags": [...] } ``` | 字段 | 作用与写法 | | :--- | :--- | | `year` | 年份锚点(整数,默认 `2025`) | | `preference_level` | 偏好档位:`normal` / `high` / `very_high` / `best`(默认 `best`) | | `artist` | 画师 / 风格 tag | | `copyright` | 系列 / 作品 tag | | `character` | 角色 tag | | `image_description` | **图像内容描述**:尽可能详细的自然语言描述 | | `extra_tags` | 用于补充图像内容的 tag | ## 🧠 训练细节(Training Details) ### 数据 - 约 **170 万张 Danbooru 图像**,全部由内部数据管线标注与筛选;训练数据截至 **2025 年 11 月底**。 - **数据管线中涉及的所有模型均由作者独立完成训练**:从图像标注、质量筛选到下文提到的偏好判别等环节,所用的都是作者自行训练的模型,而非现成的第三方模型。 - 使用上文所示的结构化 caption,其中 `image_description` 为**纯自然语言**。 - `preference_level` 档位由在约 300 万条样本上训练的偏好判别模型判定。 ### 训练动态(Training Dynamics) | 项目 | 设置 | | :--- | :--- | | 精度 | 训练整体在 **BF16** 精度下进行;MLP 与 Attention 中的矩阵乘法使用 **MXFP8 GEMM** | | 优化器 | 复合优化器:MLP 与 Attention 的二维参数由 **Muon** 更新(momentum 0.95,`match_rms_adamw`);其余参数保持 BF16 并由 **AdamW** 更新(β = 0.9 / 0.95,ε = 1e-8) | | Batch size | 1024 | | 学习率 | 4e-5 | | Weight decay | 1e-3 | | 梯度裁剪 | 1.0 | ### 训练重点 - 显著增强对 **512 token 量级自然语言描述**的理解能力,让精确描述取代 tag 随机抽卡成为默认生成方式。 - 数据质量的提升也改善了生成图像的美感:即使**不添加质量词、不填写负向提示词**,生成结果依然足够干净整洁。 ## 🔌 兼容性 - 架构与上游基座完全一致:层数、参数量与文件格式均相同,可直接替换 checkpoint。 - 使用同一套文本编码器与 VAE(Qwen3-0.6B text encoder、Qwen-Image VAE)—— 工作流无需改动。 - 单文件权重,放入 `models/diffusion_models` 即可被 ComfyUI 加载。 ## ⚠️ 局限性 - **不擅长写实**:模型面向二次元插画与非写实艺术图,照片写实风格不在其适用范围内。 - **文字渲染能力较弱**:单词与短句通常可以正确渲染,长文本的渲染效果不可靠。 ## 📜 许可证 本模型权重及其衍生模型均受 [CircleStone Labs Non-Commercial License](https://huggingface.co/circlestone-labs/Anima/resolve/main/LICENSE.md) 约束,**仅限非商业用途**。此外,本模型属于 Cosmos-Predict2-2B-Text2Image 的衍生模型(Derivative Model),因此亦受 [NVIDIA Open Model License Agreement](https://www.nvidia.com/en-us/agreements/enterprise-software/nvidia-open-model-license/) 相应条款的约束。 ## 🙏 致谢 - 基座模型:[circlestone-labs/Anima](https://huggingface.co/circlestone-labs/Anima) 系列的 Anima-Base v1.0(`anima-base-v1.0.safetensors`),构建于 [nvidia/Cosmos-Predict2-2B-Text2Image](https://huggingface.co/nvidia/Cosmos-Predict2-2B-Text2Image)。