三个估计器 × 四个真值数据集
每个方法在每个有力传感器标注的数据集上评测,逐数据集画预测 vs 真值—— 数据集质量在行内被控制,面板之间的差异就是方法之间的差异。
↖ 方法设计 3D 工作台 总览(英文) 图库 English矩阵(Spearman ρ,预测 vs F/T 真值)
| 数据集(gel 类型) | 我们——物理, 零训练帧 |
FEATS U-net (训练域:有点 gel) |
FeelAnyForce (训练域:无点) |
|---|---|---|---|
| FEATS val(有点) | 0.77 | 0.96 · 本域 | 0.43 |
| FoTa cnc_Mini(无点) | 0.95 (视野内) | 0.07 | 0.83 |
| GlowTact(无点) | 0.99 | 0.04 | 0.90 |
| Sparsh / Meta(无点,10 块 gel pad) | 0.97(视野内,自标定查找表) | 未运行 — 没有公开的预测结果 | |
这个规律比我们最初写的要窄。FEATS 确实出域即塌 (0.96 → 0.04–0.07),物理管线也确实在此处每个数据集上都能工作 (0.77–0.99)且从未见过训练数据。但 FeelAnyForce 并没有崩塌: 它在三个无 marker 数据集上保持 0.83 / 0.90 / 0.97,只在 marker gel 上降到 0.43; 而在 Sparsh 上它直接胜过我们——零标注 0.967,而我们把标定冻结到单块 pad 时为 0.860。诚实的表述是:物理管线是唯一不需要训练数据的估计器, 而不是唯一能跨域的。
每个数字都配上足以否定它的对照
在深度管线加入 marker 修补之后端到端重跑。四个数据集使用同一套协议: 在每个组内(压头族 / 探头 / 采集组 / gel pad)一半帧拟合 5 特征最小二乘模型并用保序回归标定, 另一半用于评分;5 个随机种子,报告中位数。对照列用完全相同的协议,但把力标签 在组内打乱——组结构和力的分布都不变,只破坏帧与力的配对。
| dataset | n (eval) | ρ | ρ across seeds | MAE [N] | within-group shuffle |
|---|---|---|---|---|---|
| GlowTact (markerless, 0-20 N) | 201 | 0.986 | 0.981–0.987 | 0.525 | +0.171 |
| FoTa cnc_Mini (markerless, in view) | 337 | 0.946 | 0.929–0.949 | 0.252 | +0.056 |
| FEATS (marker gel) | 186 | 0.775 | 0.713–0.787 | 5.025 | -0.003 |
| Sparsh / Meta (markerless, Sparsh LUT, in view) | 1667 | 0.968 | 0.967–0.971 | 0.042 | +0.264 |
| FEATS (marker gel, dots inpainted — rejected for force) | 186 | 0.737 | 0.682–0.816 | 4.934 | -0.010 |
没有任何数字变动。这正是预期结果,也值得明确说出来:marker 修补只被采纳用于 几何,力的路径被刻意保持逐字节不变;从原始帧重算缓存特征的抽查也证实了这一点 (40 帧 cnc 上 max |缓存 − 重算| = 0)。最后一行是同样的 FEATS 帧、同样的划分, 只是把 marker 修补后的特征喂给力模型——ρ 下降 0.037,这就是它没有进入力路径的原因。
这里正确的对照是组内打乱,而不是全局打乱:在 FeelAnyForce 上, 混合后的 ρ 在全局打乱下仍有 0.442(对比 0.455),我们正是这样发现它的帧对齐从未被验证。 读表方式:cnc 与 GlowTact 高出各自对照约 0.9;FEATS 高出 0.78,而它的对照平在 0.00。
FeelAnyForce:已恢复
此前排除它,是因为帧↔标签的对齐无法被证实。 解决办法不是更好的模型,而是更好的数据处理:不再推断 capture 内的帧索引,而是用 HTTP Range 从发布方的分卷 zip 中定向抽取带时间戳的原始图像(5,202 个成员,从 82 GB 的压缩包中 只下载 609 MB,5202/5202 通过 CRC-32 校验)。图像文件名就是标签 CSV 引用的时间戳, 所以对齐是"文件名字面相等"而非推断。
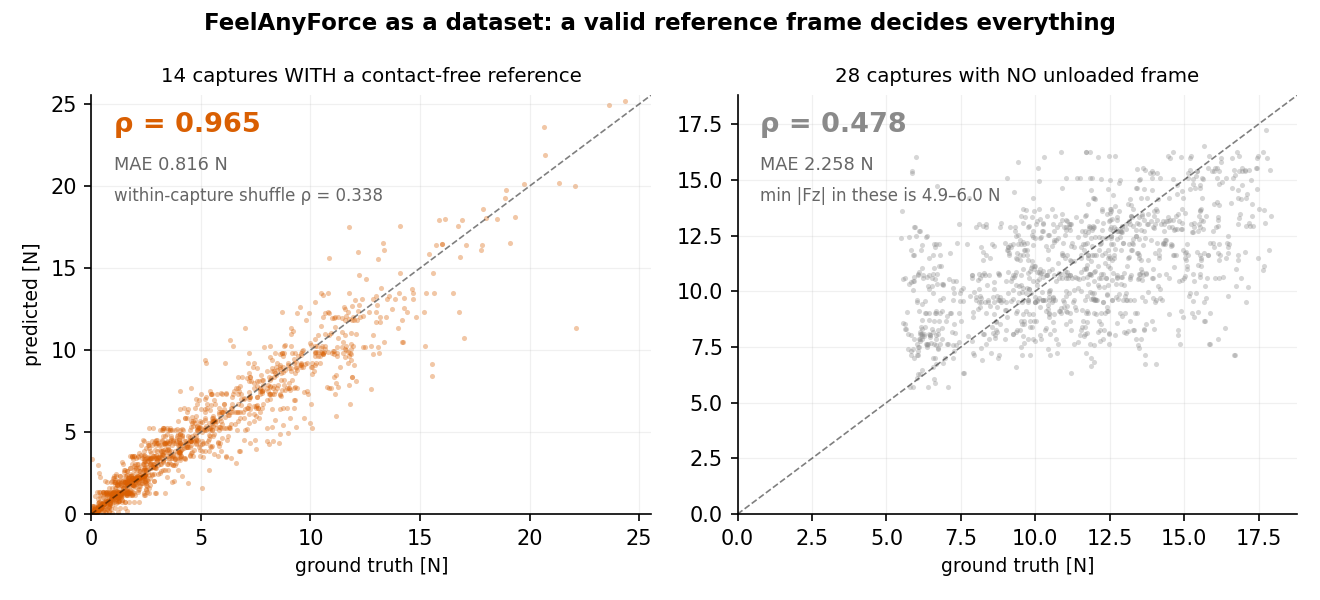
| 子集 | n | ρ | capture 内打乱对照 | MAE | 逐 capture ρ 中位 |
|---|---|---|---|---|---|
| 14 个有无接触参考帧的 capture | 1400 | 0.961 | 0.338 | 0.85 N | 0.953 [0.89–0.99] |
| 同样的帧,改用中值图像作参考 | 1400 | 0.909 | 0.335 | 1.18 N | 0.929 |
| 28 个没有无载荷帧的 capture | 1120 | 0.519 | 0.092 | 2.21 N | 0.532 |
| (此前的推断式对齐,作为对比) | — | 0.455 | 0.442 | — | ~0.09 |
对照现在被拉开 0.62,而推断式对齐只拉开 0.013。从 0.455 跳到 0.961 容易招致"是不是太好了"的质疑,所以又做了两项检验:对齐扰动——把每帧改标成 k 帧之后的力, k=1 时降到 0.603,k=25 时降到 0.430,恰好落在被否决的推断式对齐的数值上,说明文件名精确匹配 是承重的,而旧对齐的行为就像错开了几十帧;按时间分块划分(用每个 capture 时间上靠前的一半拟合) 仍有 0.912,说明随机半半分并没有在利用相邻帧。我们还发现官方 CSV 把 3,188 帧同时放进了 多个划分(train/val/test),所有重复帧的 Fz 完全一致——已按路径去重, 否则同一帧可能同时落进我们自己划分的两半。
评测过但未纳入的数据集
上表是四个 GelSight Mini 力数据集。另有两个做过工作但未纳入, 与其让读者猜,不如说清楚为什么。
| 数据集 | 为什么它不是表中一行 |
|---|---|
| FeelAnyForce(2410.02048) 42 个 capture 中的 28 个 |
现已纳入其中 14 个 capture(见上)。另外 28 个通篇没有一帧是无载荷的—— 其 |Fz| 最小值为 4.87–6.01 N,不存在有效参考帧,重建量到的是参考失配而非接触。 它们的 ρ 为 0.519(对照 0.092),单独报告而不并入头条数字。 |
| Tactile MNIST(真实划分) | 用于重建真值而非力——它没有力标签。上文的逐像素深度验证用的是它的仿真划分。 |
另外经核查因缺少牛顿单位力真值、或传感器不符而排除:Touch and Go、TVL、 TacQuad、GelSLAM、3DCal、DAR_OTS(GelSight 型号未声明,且其 marker gel 的力标签是 markerless 组的重排副本)、GenForce(仅 marker 图像,无 RGB)、AllSight(圆柱指,非平面 Mini gel)、 DIGIT 与 Wedge 系数据集。TacVerse 是唯一确认符合的 GelSight Mini 候选—— 有/无 marker、2 mm 球、0.1 mm 步进——但需申请访问权限。
FEATS 数据集——有点 gel
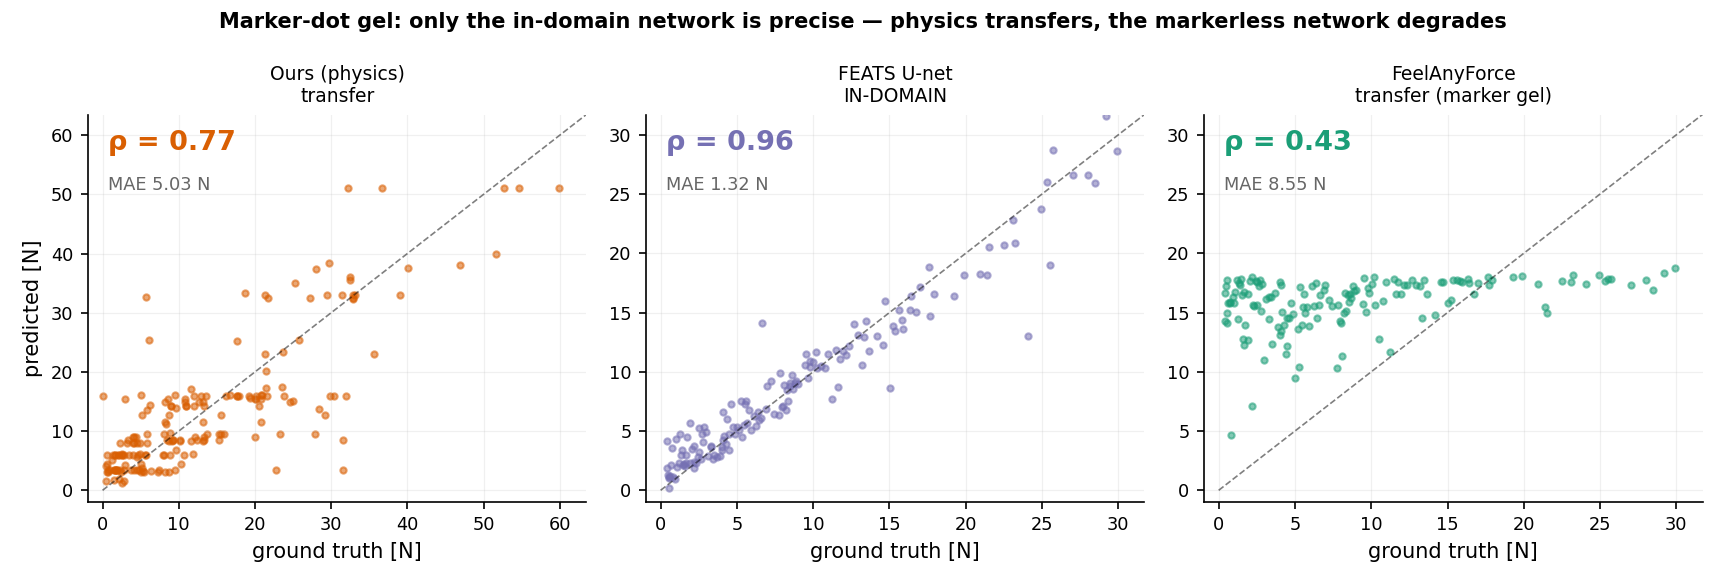
本域内 FEATS U-net 非常出色(ρ=0.96)——它在别处的失败是域效应, 不是模型弱。FeelAnyForce(无点训练)在有点 gel 上退化到 0.43:这把刀两边都割。
去掉 marker 点:几何上的胜利,不是力上的
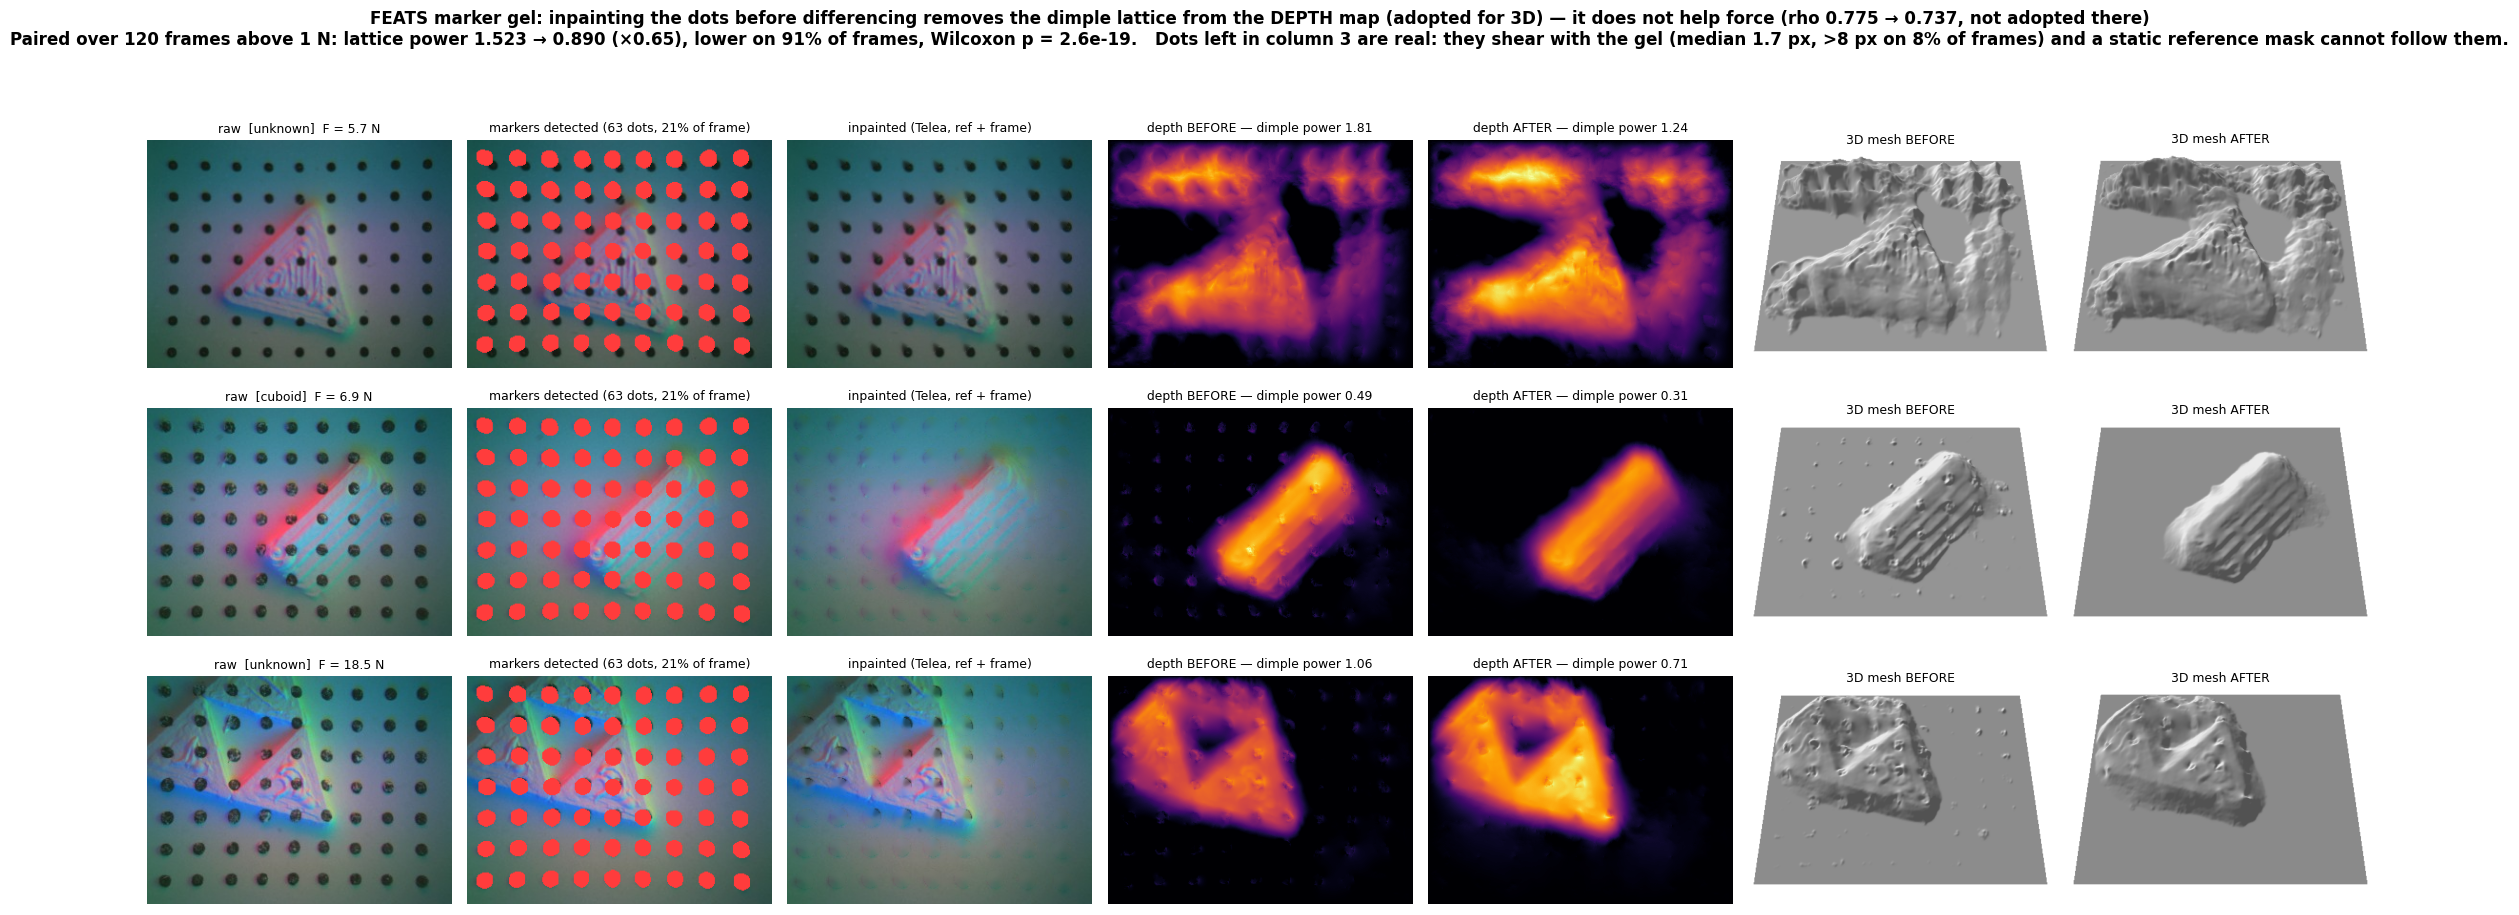
点会遮挡 gel,因此光度查找表在点下没有有效颜色,Poisson 积分会把一层 点阵凹坑积进深度图——在 3D mesh BEFORE 面板上表现为满屏麻点。在参考帧上检测这些点, 并在做差分之前把它们从参考帧和当前帧里一起修补掉(cv2 Telea,相当于 GelSight Wedge 图 10 中孔洞插值的图像域版本),凹坑就消失了:31.9 px 点距对应频率上的功率从 1.523 降到 0.890(×0.65),在 1 N 以上的 120 帧中有 91% 变低, Wilcoxon p = 2.6e-19。检测器是 marker 专用的,不是通用斑点检测器——在该参考帧上 63/63 个点、 0 个误检,阈值从 3 到 16 灰阶都稳定;而在无 marker 的 GlowTact 与 cnc 参考帧上恰好检出 0 个,此时该步骤是逐比特的空操作。
它做不到两件事。第一,它对力没有帮助:在相同帧、相同划分下 ρ 从 0.7747 降到 0.7371,且每个配对中位差都是负的,所以力特征仍然来自未改动的管线。 第二,它抓不全所有点——点会随 gel 剪切移动(中位 1.7 px,8% 的帧超过 8 px), 静态参考掩码追不上位移的点,第 3 列里残留的点就是它们。对照实验:把同样面积的 随机假 marker 修补掉得到 0.7697,即没有增益,说明这些微小变化并不是"修补=平滑=更好"。 真正卡住 FEATS 的是参考帧而非点——在最轻的 20 次按压上,点外区域的 |dI| 已经有 11 个灰阶, 88% 的点外像素通过 |dI|>8 的有效性判据,掩码几乎覆盖整幅画面,特征积分的是参考帧失配; 换成逐压头的轻压参考帧反而更差(0.7747 → 0.7261)。
FoTa cnc_Mini——无点 gel

条件苛刻:只有 4 帧无接触,62% 的按压贴边。我们严格视野内 ρ=0.95(MAE 0.25 N,见管线调试页); FeelAnyForce 非边缘达 0.92。
GlowTact——无点 gel,清洗过
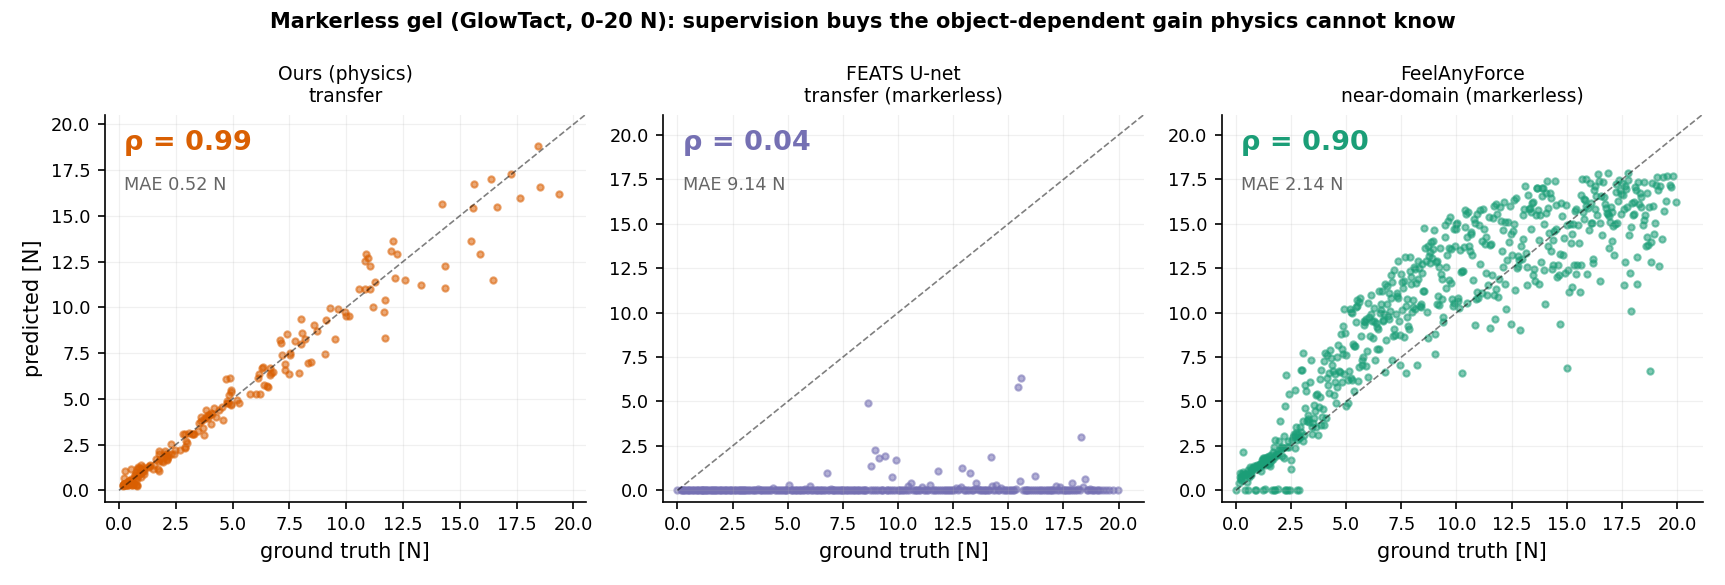
最友好的真值(按压居中、10 帧自由参考、0–20 N)。逐 indenter 在 物理作用域内(接触完全在视野、凝胶未触底)家族内标定后,六种 indenter 的 ρ 为 0.975–0.992,MAE ≤ 0.73 N。注意:该标定逐家族重拟合,衡量的是组内秩一致性, 并非可迁移的绝对牛顿刻度——见逐数据集标定。
Sparsh (Meta) — 第四个数据集,以及方法的边界
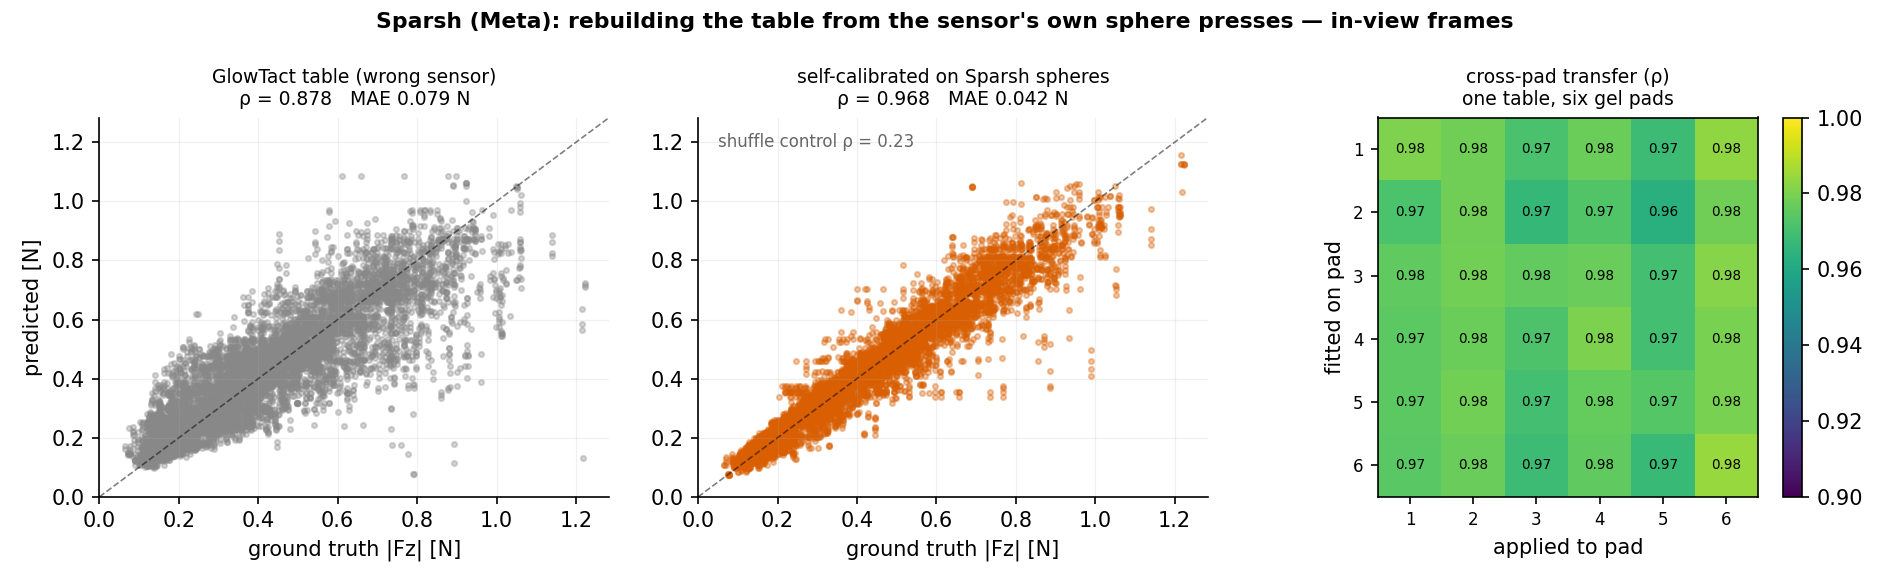
10 块 gel pad(6 球、2 平、2 尖),力为牛顿。我们用 GlowTact 标定的表应用到这个外来传感器,视野内 ρ=0.878。改用 Sparsh 自己的球压帧 重建查找表(708 帧,由 a²=d(2R−d) 拟合出 R=2.44 mm)后达到 ρ=0.968,MAE 0.042 N,对照组(pad 内打乱标签)为 0.23。 在一块 pad 上拟合后原样应用到另一块没有可测代价(各处 0.96–0.98): 一张表,六块 gel pad。
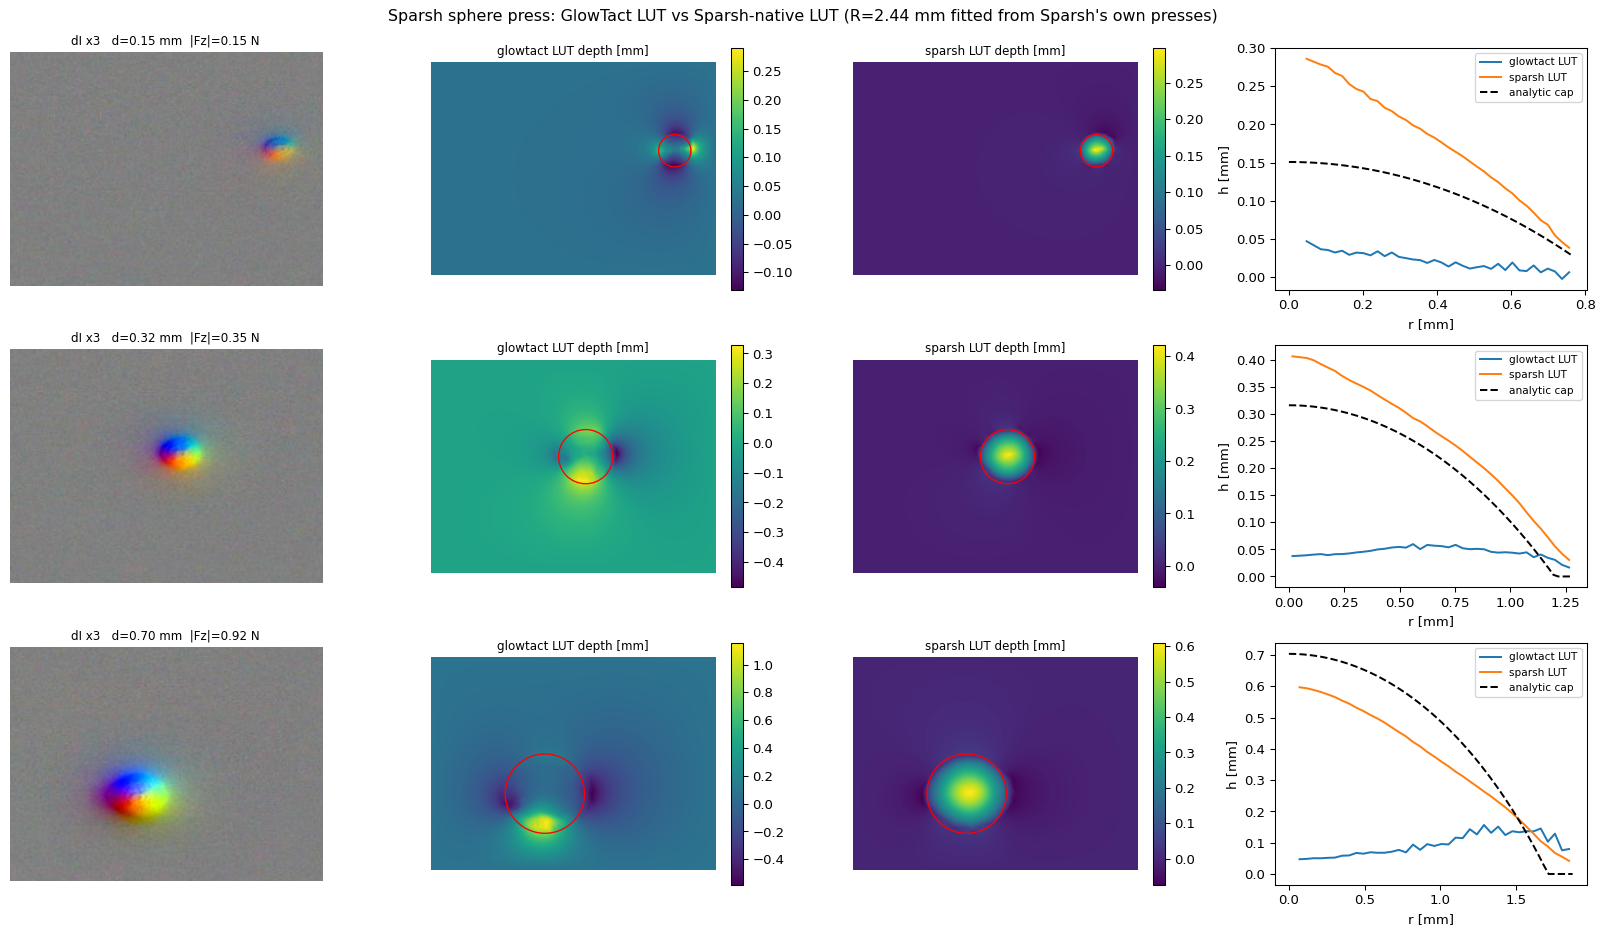
为什么"表"比"拟合"更关键:用错传感器的表,球压积分出的是 双瓣+中心凹陷;用自标定的表则是与解析球冠吻合的单一圆顶 (残差 RMS 0.179 → 0.0545 mm)。在任何积分之前测量:LUT 梯度与解析球面 梯度夹角为 93.3°(随机水平是 90°),自标定后降到 4.5° (30° 以内占比 15% → 99%)。反向对照:Sparsh 的表在 GlowTact 帧上同样失败, 所以这是逐传感器属性,而非"我们的表不好"。
代价与仍然失败之处。代价是在目标传感器上采一组带深度记录的 球压:这是每个传感器标定一次,不是零样本。秩序可以跨压头形状迁移,但 绝对牛顿不行——球拟合的模型用到平头上 MAE 退化到 0.37–0.40 N,而且 用正确的表反而更差,因为真实几何拉大了球与平头之间本就存在的特征尺度差异。 尖头不受支持(视野内 ρ 0.58)。剪切在结构上无法覆盖——无论用哪张表, 剪切最高十分位的残差都保持 1.6 倍。帧被限制为接触圆盘可见:36% 的按压检测不到圆盘、 11% 被裁切,而被裁切子集的力中位数最高却得分更差,说明这是可见性问题而非力程筛选。 另外还先修了三个数据集缺陷:flat/sharp 的轨迹里帧索引比力多 5 个(标签会静默错位, 逐轨迹配对前 ρ≈0)、sharp/batch_2 以 BGR 存储而其余九个是 RGB、 flat/batch_2 只有 3 个图像文件。
第一份外部逐像素真值——它改变了主结论
上面评的都是力。在此之前,底层的深度只被拿来和我们自己的 解析球冠比较,而球冠的幅值还是从重建本身锚定的。Tactile MNIST 补上了缺失的一环: 由 3D 打印数字网格光线投射得到的精确逐像素深度,且是球面标定无法自证的非球面几何—— 420 次触碰、106 个物体。位姿对应关系是端到端验证过的而非假设的 (用真值高度图重渲染可复现出厂图像,误差约 2/255 灰阶)。
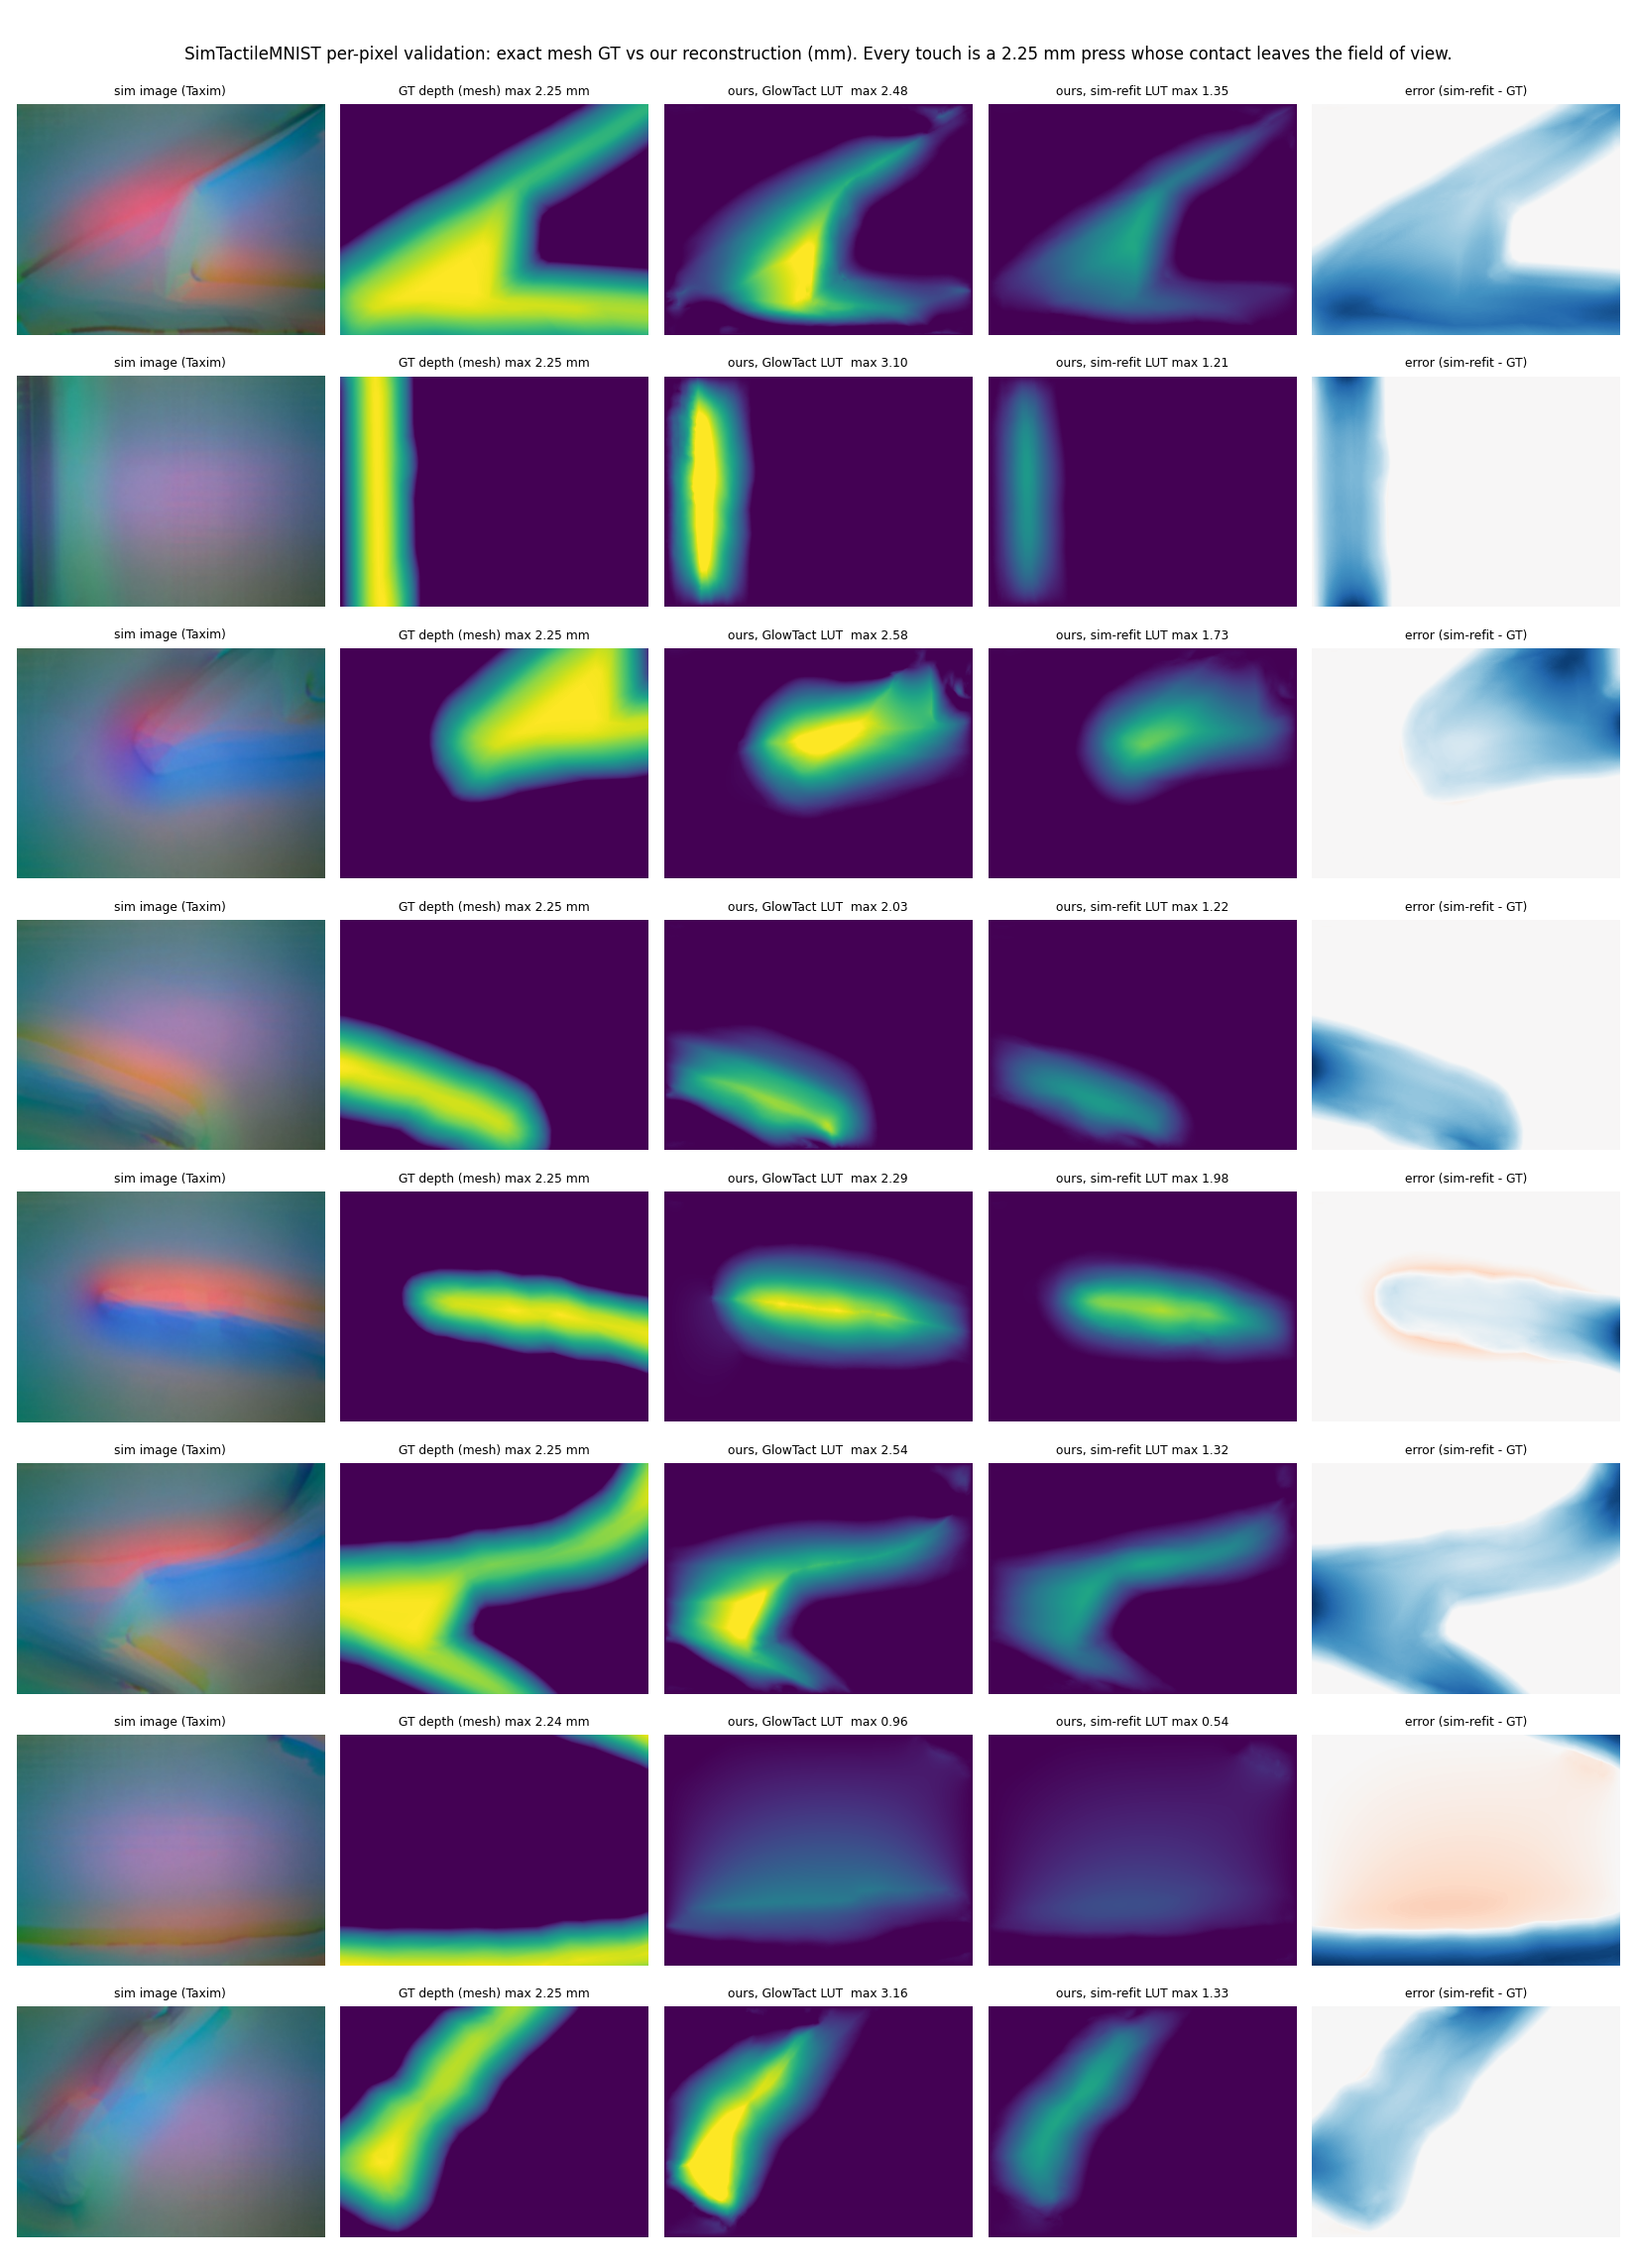
结论是一个区间,不是一个数字:精度是压入深度的陡峭函数。 同样的数字网格,在五个压入深度上重渲染,没有逐帧配准,也没有拟合压入尺度:
| 压入深度 [mm] | 0.30 | 0.60 | 1.00 | 1.50 | 2.25 — 数据集实际发布的 |
|---|---|---|---|---|---|
| MAE [µm] | 11.2 | 35.0 | 67.8 | 127.4 | 281.1 |
| Type-2 误差 [µm] | 96.5 | 186.3 | 308.6 | 514.6 | 961.8 |
| 峰值还原比(我们 / 真值) | 1.00 | 0.97 | 0.77 | 0.68 | 0.55 |
在 0.3 mm 处 Type-2 误差为 96.5 µm,低于 3D Cal 公布的全部三个数字 (152.8 / 171.6 / 290.0 µm)——而且他们的结果是带二维互相关配准和拟合压入尺度得到的, 我们两者都没有。在 0.6 mm(186.3 µm)我们落在他们的区间内。而在该数据集实际使用的 2.25 mm 压入下,我们差了一个数量级,峰值只还原了一半左右。所以:本站任何精度数字都必须连同 它所对应的压入深度一起引用,而这套重建的适用区间是浅接触。
它纠正了什么,又确认了什么。
| 此前的说法 | 逐像素真值之后 |
|---|---|
| 平头压头过度穹顶化——中心/边缘比 1.23–1.42,而 1.0 才是正确值 | 撤回。前提本身就是错的:gel 是柔顺的,会包裹平边,所以 c/r > 1 是应当出现的。真值显示被压数字的真实深度图 c/r 为 1.400 (gel 表面本身是 1.334),而我们重建出 1.539–1.562——+10–12%; 在真值恰为 1.000 的封闭平台对照上我们测得 1.069,即 +7%。 过度穹顶化真实存在但很小,不是我们暗示的 +23–42%。 |
| 多达 22% 的接触像素落在未观测过的 LUT bin 里——一个主要缺陷 | 降级。在真值集上为 13.8% / 16.9%, 与逐次触碰 Type-2 误差的相关性仅 0.098 / 0.294。 |
|dI| > 8 有效掩码被光晕主导 |
确认并量化。相对真实接触区域:IoU 0.614, 召回 0.917,过分割 0.531——它几乎找全了接触,然后又多加了半个接触面积的光晕。 |
| 出域时光度查找表可能是薄弱环节 | 排除。LUT 梯度与真实 gel 梯度的夹角在这些渲染上是 24.4°, 而同一张表在它自己的真实传感器上是 26.1°;用域内球压重渲染重新拟合查找表 也没有改善数字(316.9 vs 273.4 µm)。 |
同一个失效模式,现在已在四个数据集上看到。这里 420/420 次触碰的接触都跑出了 pad, 而一个把单个球冠从 pad 中心移到边缘的对照,使峰值从 1.39 塌到 0.30 mm (真值 0.90 mm,Type-2 292 → 450 µm)。这与 cnc_Mini 的按压网格大于视野 (视野消融实验里 ρ 0.11 → 0.94)、以及 Sparsh 中被裁切的接触圆盘虽然力中位数最高 却得分更差,是同一回事。接触可见性——而不是力程或 gel 类型——才是这条管线最大的外部失效模式: Poisson 求解的零边界无法表示一个跑出画面的曲面。
诚实的边界。这些图像是 Taxim 渲染,不是真实 GelSight 帧,
所以它验证的是几何求解器(查找表、掩码、积分),而不是传感器模型;
上面的域检查正是允许这样解读的依据。另外 Taxim 的 gel 与物体几何的偏差只有约 38 µm,
几乎没有建模真实 gel 的非贴合性:在同样压深下,真实传感器上的数字只会更差,不会更好。
复现:python -m force_recovery.mnist_validation stage1|controls|sweep。
Sparsh:唯一一个训练网络胜过我们的数据集
Sparsh 用的是无 marker 的 GelSight Mini(数据集卡原文如此), ATI nano17 真值,载荷至 3 N,三种压头。我们此前从未在它上面跑过基线。 在完全相同的帧上补跑——同样的 pad、同样的视野内掩码,我们的物理列复算得 ρ=0.9682 与既有工件逐位一致——得到一个不舒服的答案。
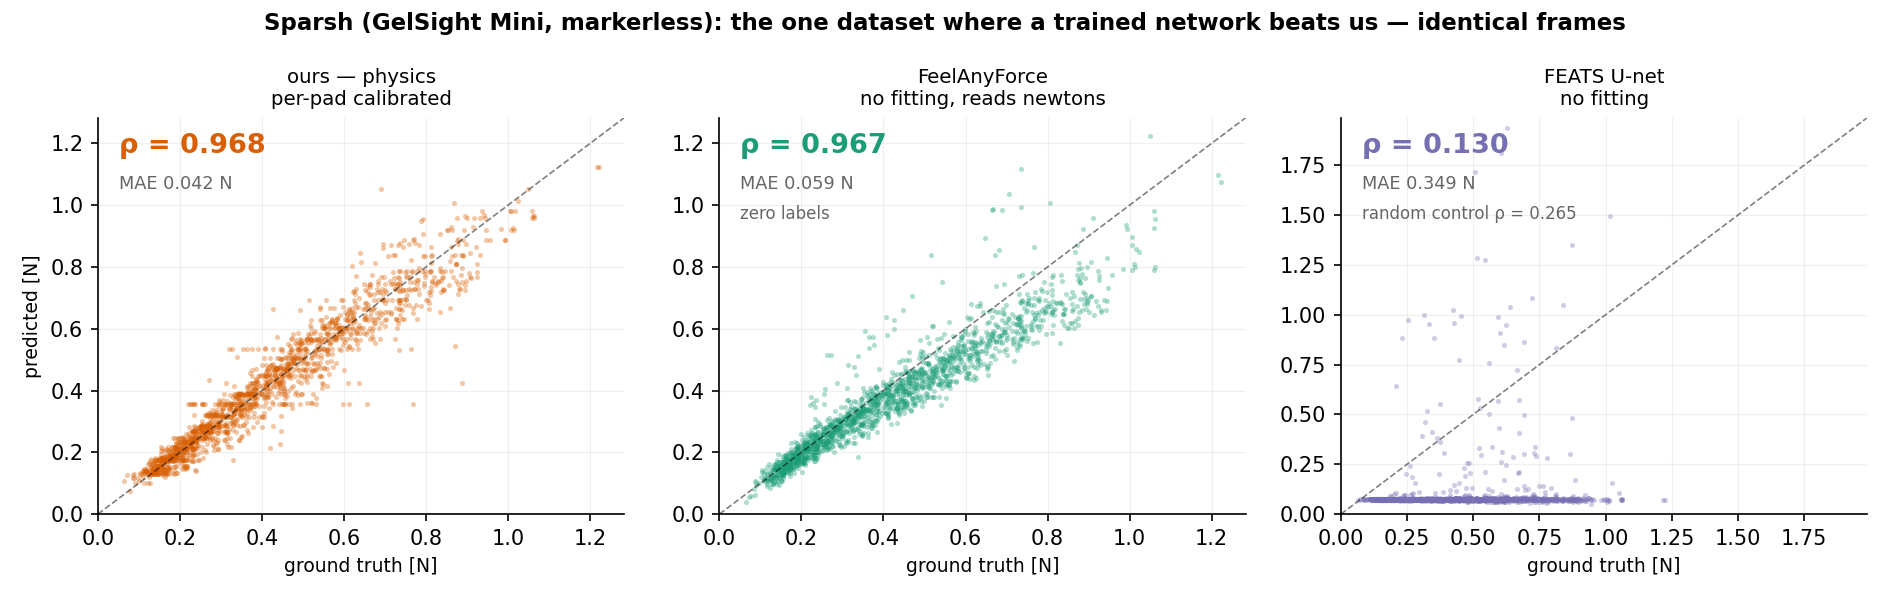
| 口径 | 我们(物理) | FeelAnyForce | FEATS U-net | 随机对照 |
|---|---|---|---|---|
| 无拟合,直接读牛顿 | 不适用——我们的输出是 mm³ | 0.967(MAE 0.060 N) | 0.086 | — |
| 逐 pad 半半分 + isotonic | 0.968(0.042 N) | 0.985(0.030 N) | 0.384 | 0.265 |
头条应取无拟合那一行:两个基线都是直接输出牛顿的预训练模型, 而 Sparsh 的标签也是牛顿,所以“能直接读出力”与“逐 pad 重新校准后才相关” 是两个不同的主张。FeelAnyForce 完胜:零标注下 0.967,而我们把校准冻结到 单块 pad(467 个标注)时只有 0.860。逐 pad 重校准掩盖了这个差距。它也不需要视野内过滤—— 在全部 7500 帧(含出画面的接触)上它保持 0.897,而我们掉到 0.683。 在我们最弱的 sharp 压头上,它 0.878 对我们 0.619。
FEATS 的 0.384 不是信号。同协议下纯噪声列得 0.265, 而 isotonic 可以通过选符号把它逐 pad 的 −0.099 翻成 +0.261。它的预测四分位距是 0.002 N,而真值是 0.341 N——93% 的帧落在它自己中位数的 ±20% 内, 其 MAE(0.341 N)差于直接预测一个常数(0.181 N)。它是卡住了,不是算错了。
两个会翻转结论的预处理事实,记录在此以免重复推导:Sparsh 的 320×240 帧已经是 gsdevice 裁过的,再套一次我们的 1/7 边框裁剪会让 FeelAnyForce 从 0.985 掉到 0.976;背景相减是死线——不减背景时模型钉在 18.4–19.5 N,ρ 变负。
力作为 observation,以及由它导出的 action
估计出的法向力被写回数据集,连同它蕴含的动作:36 个 episode、 72 个 sensor-side、240,040 行、480,080 个力样本。行数对齐 72/72 全部通过, 人为截断的文件会报错退出而不是静默截断。
| 新增列 | 含义 |
|---|---|
force_{side}_normal_n | 估计法向力 [N] |
force_{side}_penetration_mm | F / k |
force_{side}_target_pose | 观测位姿沿接触法向推进 F/k(位置 + 四元数一并带出) |
按压方向不是某个坐标轴:它来自装置的双球标定
(位姿间一致性 ≤1.07°),若天真地猜“工具 z 轴”会偏
71–108°。并且用纯运动学独立验证过(不依赖该标定):力上升期
v·n̂>0 的 sensor-side 占 94.3%,
corr(ΔF, v·n̂) 为正的占 95.7%。
自由空间是严格恒等——219,518 个无接触行的
max|target − observed| = 0 逐元素成立,往返
k·‖target−observed‖ = F 闭合到 5.8e-14 N。
重跑导出可得逐字节相同的文件。
1 N/mm 是声明的起点——而全量数据说它偏软
刚度是关于环境的假设而非实测属性, 所以它被写进 parquet 字段元数据和数据旁的 sidecar,而不是只存在代码里。 在全部 480,080 个样本上实测,它不成立:
| k [N/mm] | p95 穿透 | 最大 | 超过 4.25 mm 凝胶 |
|---|---|---|---|
| 1.0(当前导出) | 5.69 mm | 23.8 mm | 7.85% |
| 1.5 | 3.79 mm | 15.9 mm | 3.86% |
| 3.0 | 1.90 mm | 7.9 mm | 0.31% |
| 5.6 | 1.02 mm | 4.26 mm | 0.00% |
若把穿透读作虚拟阻抗偏移,3–6 N/mm 能让指令目标 留在凝胶内;若读作真实凝胶压缩,估计器自己的 F / 最大压深 给出中位 15.4 N/mm(p5–p95 为 5.3–34.7)。1 N/mm 只在约 4 N 以下站得住。 本页早前版本曾据单个 sensor-side(力上限仅 2.3 N)推断“0% 超出凝胶”, 全量数字已使该说法作废。
React——没有真值,那就问:独立方法是否一致?

在我们真正关心的数据集上,两个幸存的估计器——物理(零训练)与 FeelAnyForce(20 万帧)——一致性 ρ=0.91,且物理管线判无接触的每一帧它都读 ≈0 N。 彼此无法抄袭对方的错误。
结论
给 React 打标签(无点 Mini):FeelAnyForce 主标, 物理管线独立审计,分歧行打标。换任何新 gel 或新传感器、没有训练模型匹配该域时: 物理管线是唯一开箱即用的选项——它在 FEATS 数据集上的 0.77 就是"无人为它调过的域"上的表现。
并且要把适用范围一起说清楚。上面那些 ρ 是逐组的力得分。 底层的深度现在已经用精确逐像素真值测过,它是压入深度的强函数—— 0.3 mm 处 MAE 11 µm,2.25 mm 处 281 µm——所以诚实的一句话总结是: 浅接触几何精确、标定组内力单调,而一旦接触跑出视野,两条结论都不成立。 有 marker 的 gel 多一步(差分前把点修补掉),它买到的是几何,不是力。
管线调试页:三个数据集上从原始图像到力的逐步展示,以及 cnc 视野消融(视野内 ρ=0.95)。