从 GelSight 图像到法向力,一页讲完
无 marker gel,无 F/T 传感器,没有一帧来自我们平台的训练数据。 一条只有一个拟合参数的物理管线。
↖ 评测结果 总览(英文) 动作变换 English管线——六步
nnmini):三色照明使 颜色→法向 可逆后处理:只在 fresh 触觉帧上做 3 点中值(逐行滤波会把重复行里的坏值数三次)。 单帧尖峰从 4–8% 降到 ≈0。
光度重做——经典逐传感器标定(v2)
Ground-truth depth supervision (commanded press depth in GlowTact) exposed that the generic depth MLP recovers only ~25% of true indentation and saturates (peak-depth ρ = 0.39) — and, deeper, that the gsrobotics SDK's Poisson solver returns 39% of the amplitude even on a perfect synthetic gradient field (line-integral proved the gradients were correct at 105%). Rebuilt on the classic Dong/Yuan calibration: difference image → per-sensor RGB lookup table, self-calibrated from GlowTact's spherical presses via the exact relation a² = d(2R−d) (R = 3.35 mm, no external data) → exact Poisson (Dong's fast_poisson, 100.7% on the same benchmark) → sphere-supervised spatial gain field → Drake-style stiffening foundation p = k₁δ + k₂δ² with imprint-derived shape conditioning.
| stage (held-out, GlowTact 0–20 N) | ρ | MAE |
|---|---|---|
| MLP + linear Winkler (v1) | 0.63 | 4.4 N |
| LUT + solver fix + gain field + nonlinear foundation | 0.80 | 2.75 N |
| + imprint shape self-conditioning | 0.82 | 2.46 N |
| spheres only (geometry exact — the method's ceiling) | 0.91–0.94 | 1.5–1.9 N |
| spheres × 0–8 N (React's operating range; 7-seed median, +isotonic) | 0.95 (0.93–0.96) | 0.78 N (0.73–0.84) |
Ceiling context: the CNC's own commanded depth predicts force at ρ = 0.975. The remaining pooled gap is object-dependent contact mechanics; sub-newton MAE on 0–20 N exceeds what geometry alone carries (the 200K-frame supervised network reaches 2.1 N on the same range). A new sensor needs one 2-minute ball-press pass — a calibration the React rig can adopt.
验证(LUT-v2 管线)
LUT-v2 管线在三个带力标注的数据集(FEATS、FoTa cnc_Mini、GlowTact)上验证,并与两个神经网络估计器同帧对比——每个数据集的预测 vs 真值散点图都在评测结果页。一句话版:物理方法在所有域 0.74–0.99(GlowTact 0.98、cnc_Mini 视野内 0.94、FEATS 0.77);每个网络在自己的 gel 域 0.90+,出域即塌。
逐数据集标定
这一点值得直说,因为它界定了上面那些 ρ 的含义:管线里没有任何硬度或弹性模量常数。代码不知道任何 gel 的邵氏硬度或杨氏模量。刚度只是隐式进入——被逐组最小二乘的权重、以及叠在其上的保序(isotonic)标定吸收掉了——而这些都是逐数据集、逐压头/探头组重新拟合的:每个 cnc_Mini 探头、每个 GlowTact 压头族、每个 FEATS 采集组各自拟合,组内一半拟合、一半留出。
跨数据集共享的物理常数只有两个:球面标定出的 RGB 查找表,以及 MM_PER_PIXEL。深度之后的一切都会重新拟合。因此报告的 ρ 是逐组的秩相关——它说明从图像恢复的几何在组内与力单调相关,但不说明存在一个可跨 gel 迁移的绝对牛顿值模型;我们唯一试过的多物体混合拟合差得多(ρ 0.47),这正是选用几何已知的球体作标定物的原因。
下面的重建也不是它看上去的那个噪声源,而且这是量出来的、不是假设的:深度场里的高频成分只占峰值深度的 0.3%(1.9 mm 按压上是 6.5 µm),而梯度场里是 22.2%——来自 LUT 分箱量化,9.8% 的接触像素落在球面标定从未观测到的 bin 里(用最近邻填充)。Poisson 积分本身就是低通,所以到深度这一步 LUT 噪声已经没了;梯度域调试面板里看到的麻点根本进不到力特征里。
用真值驱动的优化
cnc_Mini 的力标签把管线的弱点变成了可测量的缺陷,依次修复 (每一步都在留出集上验证):
| 步骤 | 驱动它的证据 | ρ(留出 val) |
|---|---|---|
| 基线(体积,逐集零图) | — | 0.34 混合 |
| + 散布按压的中位数零图 | 2686 帧里只有 4 帧真无接触;最低力参考帧带着 1.7 N 的既有接触 | ≈ 不变(零图不是瓶颈) |
| + 照明平场归一 | 力拟合残差与接触位置相关(|ρ| 达 0.6);按探头×象限条件化 ρ 0.45→0.55——渐晕在调制深度 MLP 的增益 | 0.44 混合 |
| + 边缘过滤(接触质心距边 > 3 mm) | 贴边按压处渐晕最陡,印痕还会出传感器边界 | 0.65(探头中位 0.64) |
体积还是最大深度?实证裁决:体积家族胜出(δ1.5 加权 0.65、 纯体积 0.63)优于最大深度(0.63),明显优于接触面积(0.35);3 特征小线性模型 ρ 持平 但 MAE 减半(0.61 N)。天花板也要认识:连 CNC 自己的指令压深在探头内也只有 ρ 0.78–0.88——同样深度下力确实随纹理和位置变化。
图库
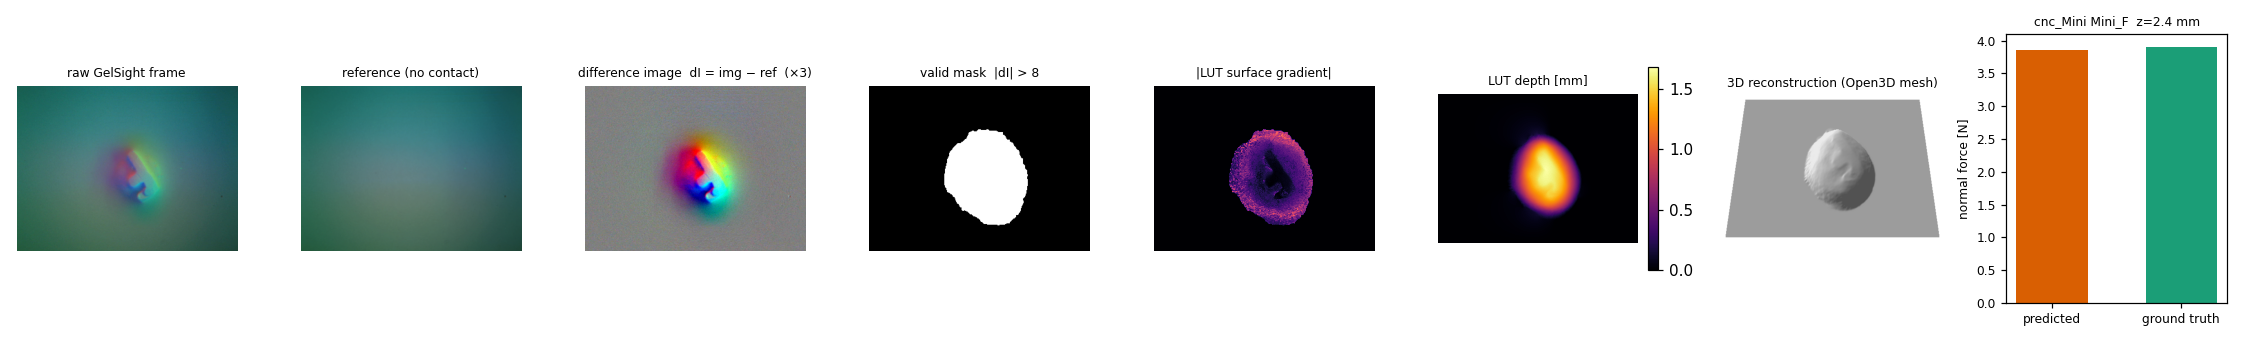
20 个图像样本(原图 | 压入图 | 重建的 Open3D 网格 | 预测 vs 真值力) 与 10 个 React 片段(触觉 | 实时深度 | 实时 Open3D 网格 | 力曲线):浏览完整图库。网格面板在每一个新触觉帧上重新渲染。
GelSight Mini 上 NN 与 model-based 谁对比过?
没有找到公开发表的正面对比。 文献分成互相引用但不互相 benchmark 的两个阵营。 Model-based:marker 位移 × 弹性理论 (Yuan 2017)、 光度立体高度图 + 多项式拟合、逆有限元 (GelSlim, Ma 2019)。 学习类(专门在 Mini 上): CANFnet(F/T 标注,仅法向)、 FEATS(FEA 标注,3D 分布)、 FeelAnyForce(20 万 ATI 标注)。 它们都只定性地论证 NN 优于物理方法——FEA 太慢、线性弹性抓不住弹性体非线性—— 但论文里对比的 baseline 全是其他网络,没有物理管线。
因此我们的 FEATS 实验算是少数直接对比数据点之一:物理管线只用一个拟合标量、 零训练帧,达到 ρ 0.70–0.85;NN 在域内能到亚牛顿 MAE,但出了自己的 gel 就失效 (FEATS 在我们的无点 gel 上完全无响应)。这是可移植性与域内精度的取舍—— 选哪个取决于你能否在自己的传感器上采标注。
还能怎么改进——learning 有用吗?
五个候选改进,每个都配了一个足以否定它的对照。两个存活。复跑:
python -m force_recovery.improvement_study all。
| 思路 | 结果 | 结论 |
|---|---|---|
| 提取剪切敏感特征 残差与剪切相关 ρ 0.31–0.40 |
把真实剪切作为预言机特征喂进去,ρ 仅 0.9749 → 0.9757 (MAE 0.0360 → 0.0345) | 关闭——相关性是混杂的, 两者都随力的大小变化 |
| 在同样特征上用小神经网络 | MLP 32×16 0.967 · MLP 64×64 0.972 · 梯度提升 0.972, 而线性+isotonic 为 0.974 | 无用——每块 pad 仅约 400 帧视野内数据,柔性模型过拟合 |
| 对数特征(误差是乘性的) | ρ 0.9735 → 0.9822,MAE 0.0361 → 0.0310(−14%) | 采纳 |
| “PINN-lite” 量纲无关接触律 F/A = g(δ/√A) | 在 球→平 上看似决定性(MAE 0.426 → 0.150 N,胜过 MLP 的 0.297)—— 但 F = g(体积) 达到 0.0736 N | 否决——增益来自“用一个单调特征而非五个”, 不是那个物理形式 |
| 让模型复杂度匹配迁移场景 | 见下 | 采纳 |
唯一真正的结构性发现:单一单调的体积特征在未见过的压头形状上比五特征模型 泛化得更好,而一旦该形状已被标定,五特征仍然更优。在 GlowTact 留一压头交叉验证中 (模型从未见过被留出的形状),这恰好修复了我们此前报告的两个短板:
| 留出的压头 | 五特征 ρ | 仅体积 ρ |
|---|---|---|
| round | 0.958 | 0.993 |
| star | 0.977 | 0.991 |
| quad_small | 0.989 | 0.997 |
| B / quad / triangle | 0.981–0.995 | 0.986–0.996 |
现在每个被留出的压头都达到 ρ ≥ 0.986,而模型从未见过该形状—— 这比结果页上“逐压头标定”的数字是更强的论断(后者是在各家族内部拟合的)。 代价在绝对牛顿:形状已知时五特征的 MAE 仍更优(Sparsh 跨 pad 0.0372 vs 0.0443 N), 所以规则是:未见形状用仅体积,已标定则用五特征。把物理律里的 g 换成学习模型会完全崩溃 (ρ −0.249):isotonic 在训练范围外单调截断,而网络会自由外推。