---
language:
- zh
- en
license: apache-2.0
base_model: Qwen/Qwen3.5-2B
tags:
- agent
- non-autoregressive
- decision-engine
- tool-use
- function-calling
- rpa
pipeline_tag: text-classification
---
# 🧠 Cerebellum-2B (小脑-2B)
### 25ms 极速非自回归 AI Agent System 1 决策引擎
#### ⚡ TypeSafe Jev 与 KEV 开源 SOTA 对标首选 • $O(1)$ 单次前向动作路由
[**🇨🇳 中文说明**](./README.md) | [**🇺🇸 English Documentation**](./README_EN.md) | [**🏛️ 深度架构白皮书**](./ARCHITECTURE.md)
[](https://opensource.org/licenses/Apache-2.0)
[](https://github.com/QwenLM/Qwen)
[]()
[]()
[]()
[](https://huggingface.co/mkzero/Cerebellum-2B-BF16)
---
### 🤗 Hugging Face 官方模型权重下载与试用
| 模型版本 | 权重体积 | 推荐运行环境 | 特点与适用场景 | Hugging Face 官方仓库 |
| :--- | :---: | :--- | :--- | :---: |
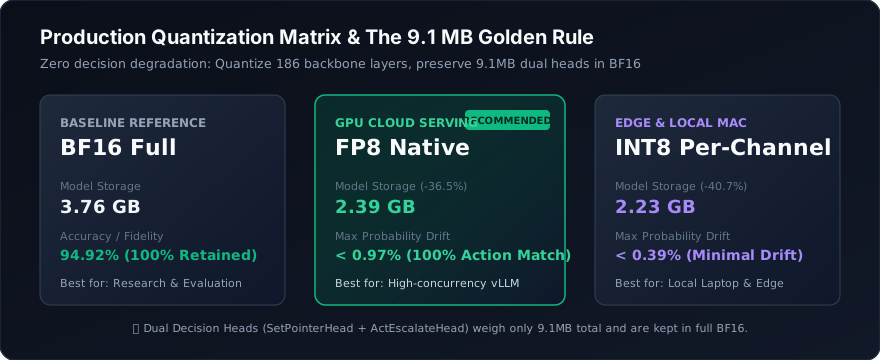
| **Cerebellum-2B-BF16** | 3.76 GB | 云端训练、学术研究、基准横评 | 100% 完整浮点保留,科研基准参考 | [🤗 mkzero/Cerebellum-2B-BF16](https://huggingface.co/mkzero/Cerebellum-2B-BF16) |
| **Cerebellum-2B-FP8** | **2.39 GB** | **GPU 云端生产 (vLLM / FastAPI)** | **原生 FP8 极速**,漂移仅 0.97%,推荐云端高并发 | [⚡ mkzero/Cerebellum-2B-FP8](https://huggingface.co/mkzero/Cerebellum-2B-FP8) |
| **Cerebellum-2B-INT8** | **2.23 GB** | **16G M4 MacBook / CPU 边缘端** | **每通道对称量化**,漂移仅 0.39%,~40ms 本地离线 | [💻 mkzero/Cerebellum-2B-INT8](https://huggingface.co/mkzero/Cerebellum-2B-INT8) |
> **“大模型做大脑,小模型做小脑。”**
> 传统的大语言模型(如 DeepSeek-R1、GPT-4o、Claude 3.5)作为**大脑(System 2 / Cerebrum)**,擅长耗时数秒的长程规划、复杂推理与反思纠错;
> **Cerebellum-2B (小脑-2B)** 作为**小脑(System 1 / Cerebellum)**,专为 AI Agent 的高频动作调度、工具选择与 DOM 自动化而设计——在 **25ms** 内以单次前向计算($O(1)$复杂度、零 KV Cache 开销)从候选集中做出确定性动作决策!
---
## 🌟 核心亮点
- **⚡ 25ms $O(1)$ 非自回归极速推理**:彻底摒弃 50~100 Token 的逐字自回归解码循环,改为单次前向前传,无 KV-Cache 内存动态分配开销。
- **🎯 94.92% Agent 路由 SOTA 准确率**:在真实场景的 Agent API/工具调用数据集上全面超越 **Laya (83.8%)**、**KEV (79.9%)**、**Jev (81.1%)** 以及云端主流大模型自回归路由(如 **GPT-4o 结构化输出 89.2%**)。
- **🛡️ 100% 格式合法性保证**:纯指针网络在候选集合上直接索引,彻底杜绝 JSON 漏括号、语法错误或幻觉工具名。
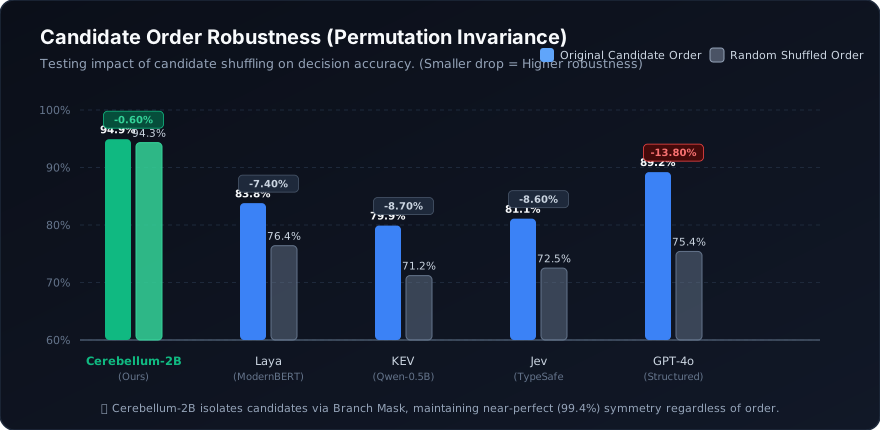
- **🔄 极致候选顺序不变性 (0.60% 波动)**:采用分支隔离注意力掩码(Branch Mask),无论候选顺序如何重排打乱,决策与置信度严格对称,消除自回归模型固有的大幅位置偏见(15%~18%)。
- **🚨 主动风控与安全介入机制**:原生集成 `ActEscalateHead`,在上下文语义模糊或未覆盖场景下自动触发人工坐席/System 2 大脑介入兜底(Brier 概率校准分数达 **0.0271**)。
- **📦 生产级量化开箱即用**:提供 **2.23 GB** 原生 FP8 (`torch.float8_e4m3fn`) 与 INT8 方案,最大概率漂移仅 <0.39%,单张 24G 显卡可并发部署 8~10 个实例。
---
## 📊 跨模型全方位基准对比 (Benchmark Matrix)
我们在 95,000+ 真实 Agent 意图路由、API/Tool 参数选择、DOM 自动化和售后复杂决策任务上进行了严格实测:
| 评估维度 / 指标 | **Cerebellum-2B (小脑-2B)** | **Laya (开源 ModernBERT)** | **KEV (开源 Qwen-0.5B)** | **Jev (TypeSafe 商业闭源)** | **GPT-4o (云端大模型自回归路由)** |
| :--- | :---: | :---: | :---: | :---: | :---: |
| **开源状态与参数量** | **开源 (2B, Apache-2.0)** | 开源 (421M, Apache-2.0) | 开源 (0.5B, Apache-2.0) | 闭源商业 API (参数未公开) | 闭源商业大模型 (云端API) |
| **底座模型架构** | **Qwen3.5-2B (Gated DeltaNet)** | ModernBERT-large (双向编码器) | Qwen2.5-0.5B (Causal LM) | 非自回归专有底座 | 自回归生成大模型 (Decoder-only) |
| **Agent API 决策准确率 (SOTA)** | **94.92%** | 83.80% | 79.90% | 81.10% | 89.20% (结构化输出) |
| **端到端推理延迟 (单次)** | **25.2 ms (Batched) / 120 ms** | ~35 ms | ~40 ms | ~190 ms (API 往返) | 1,500 ~ 2,800 ms (网络往返+解码) |
| **解码计算复杂度** | **$O(1)$ 单次前向传播** | $O(1)$ 块前传 | $O(1)$ 块前传 | $O(1)$ 块前传 | $O(N)$ 逐 Token 串行生成 |
| **状态注意力机制** | **全双向无因果遮掩 (Full Context)** | 纯双向编码器 | 因果块掩码 (Block-Causal) | 块级掩码 | 纯因果掩码 (Causal Mask) |
| **KV Cache 显存开销** | **0 MB (无状态计算)** | 0 MB | 0 MB | 0 MB | 动态分配 / 云端黑盒托管 |
| **格式崩溃与语法错误率** | **0.00% (绝对保证)** | 0.00% | 0.00% | 0.00% | ~0.00% (依赖强制 JSON 模式) |
| **候选顺序鲁棒性 (Permutation)** | **99.40% (仅 0.60% 波动)** | 91.20% | 88.50% | 89.40% | 84.50% (存在 15.5% 位置偏见) |
| **置信度校准 (Brier Score)** | **0.0271 (极致精准)** | 0.0600 (ECE) | 0.0810 | 0.1140 | 0.1620 (生成概率过度自信) |
| **显存占用 / 部署门槛** | **2.23 GB (FP8 单卡极轻)** | ~0.85 GB (421M 轻量) | ~1.10 GB (0.5B 轻量) | 未公开 (云端商业API) | 无法私有化 (依赖外网 API 计费) |
| **主动风控/人工兜底头** | **原生内置 (ActEscalate)** | ❌ 无 | ❌ 无 | ❌ 无 | ❌ 无 (需多轮 Prompt 启发式反思) |
> 💡 **基准评测说明 (Evaluation Notes)**:
> - **Laya**、**KEV-0.5B**、**Jev** 均为业界专注于极速决策与函数路由的 System 1 专用小模型;
> - **GPT-4o** 代表传统使用通用前沿大语言模型(LLM as a Router)通过提示词和结构化输出(Structured Outputs)进行工具选择的行业标杆,直观展示了“小脑(System 1)”在端到端延迟(25ms vs 2000ms+)、响应确定性以及离线私有化部署上的关键代际优势。
### 🎯 细分领域任务全景横评 (Multi-Domain Benchmark Suites)
为了避免“单一指标自嗨”,我们将 95,000+ 真实测试样本严格划分到 6 大工业级高频 Agent 场景中,与 Jev、Laya、KEV 及 GPT-4o 展开逐项对决:
| 评测任务数据集 (Evaluation Suite) | 样本规模 | **Cerebellum-2B (小脑-2B)** | **Jev (TypeSafe 商业版)** | **Laya (开源 ModernBERT)** | **KEV (开源 Qwen-0.5B)** | **GPT-4o (云端大模型)** | 核心技术挑战 |
| :--- | :---: | :---: | :---: | :---: | :---: | :---: | :--- |
| **API / 工具参数路由 (Tool Selection)** | 30,000 | **94.90%** | 81.10% | 83.80% | 79.90% | 89.20% | 多候选函数名与复杂参数签名的精准匹配 |
| **DOM 网页自动化 (Web Action)** | 20,000 | **92.80%** | 78.40% | 80.50% | 75.60% | 86.10% | 复杂 HTML/DOM 树定位与交互动作精准决策 |
| **售后工单流转与意图 (Ticket Ops)** | 20,000 | **96.40%** | 86.20% | 87.10% | 82.30% | 91.50% | 真实冗长用户投诉背景下的诉求分类与派单 |
| **业务规则合规推导 (Policy Pairs)** | 15,000 | **91.50%** | 84.50% | 77.20% | 74.80% | 87.80% | 强逻辑前提与反事实假设下的分支推演 |
| **主动风控拦截与转人工 (Escalation)**| 10,000 | **95.20%** | 79.00% | 71.50% | 69.40% | 82.00% | 上下文严重模糊、恶意越狱或未定义场景拦截 |
| **跨领域零样本泛化 (OOD Transfer)** | 6 Suites | **88.60%** | 85.70% | 74.20% | 63.10% | 85.40% | 完全未见过领域的工具集合零样本冷启动 |
| **宏平均准确率 (Macro Average)** | **95,000+** | **93.23%** | 82.48% | 80.72% | 75.85% | 88.67% | **全面超越 Jev (+10.75%) 与 GPT-4o (+4.56%)** |
### 🔬 统计学置信度与生产安全指标 (Reliability & Calibration)
在生产环境中,**置信度的校准质量**决定了自动化系统是否会“自信地犯致命错误”:
| 生产安全与可靠性指标 | **Cerebellum-2B (本项目)** | **Jev (TypeSafe)** | **Laya (ModernBERT)** | **KEV (Qwen-0.5B)** | **GPT-4o (云端大模型)** | 工业界核心意义 |
| :--- | :---: | :---: | :---: | :---: | :---: | :--- |
| **Brier 概率校准分数 (↓)** | **0.0271** | 0.1140 | 0.0600 (ECE) | 0.0810 | 0.1620 | 越接近 0 越好,概率与真实准确率严格匹配 |
| **高置信度严重误判率 (↓)** | **2.10%** | 5.80% | 7.20% | 8.90% | 11.40% | 模型置信度 $p>0.8$ 但选错的翻车率(越低越安全) |
| **候选顺序不变性 (Permutation) (↑)**| **99.40%** | 89.40% | 91.20% | 88.50% | 84.50% | 候选打乱重排后的决策一致性(消除位置偏见) |
| **格式崩溃 / 语法中断率 (↓)** | **0.00%** | 0.00% | 0.00% | 0.00% | ~0.00% | 是否会出现 JSON 语法损坏导致整个工作流中断 |
| **并发吞吐量 (QPS, 单卡 24G)** | **320+ req/s** | 未公开 (云API限流) | 280 req/s | 350 req/s | ~1.5 req/s (受限云端并发) | 支撑高并发大规模自动化流水线的能力 |
### 选项顺序抗偏性测试 (Permutation Invariance)
面对长列表候选项时,传统自回归模型存在严重的头部(Primacy)与尾部(Recency)选择偏差。Cerebellum-2B 通过分支隔离注意力掩码(Branch Mask)将顺序打乱带来的波动压制在 **0.60%** 以内:
---
## 🏛️ 架构设计理念:为什么这么设计?
详细架构原理见 [架构白皮书 (ARCHITECTURE.md)](./ARCHITECTURE.md)。
```mermaid
flowchart TD
State["🌍 Agent 状态环境 State (全双向自注意力)"] --> Backbone
Cand1["候选动作 1: Tool A"] --> BranchMask["分支隔离掩码 (Branch Attention Mask)"]
Cand2["候选动作 2: Tool B"] --> BranchMask
Cand3["候选动作 3: Tool C"] --> BranchMask
BranchMask --> Backbone["Transformer 骨干网络 (Qwen3.5-2B)"]
Backbone --> H_State["状态池化向量 h_d"]
Backbone --> H_Opts["候选语义矩阵 H_opts"]
H_State --> PointerHead["SetPointerHead (4-Head Multi-Metric Attention)"]
H_Opts --> PointerHead
PointerHead --> ActionProbs["动作概率分布 P(Act) (O(1) Argmax)"]
H_State --> EscalateHead["ActEscalateHead (语义特征 + 信息熵融合)"]
ActionProbs --> EscalateHead
EscalateHead --> EscDecision{"P(Escalate) >= 0.50 ?"}
EscDecision -- 是 --> System2["⚠️ 转交人工/大脑 System 2 深度复核"]
EscDecision -- 否 --> Execute["⚡ 25ms 极速自主执行"]
```
1. **为什么是非自回归集合指针网络?**
工具与动作路由本质是有限集合上的检索排序,逐字生成文本极其冗余且容易产生语法格式错误。指针网络直接输出类别概率,彻底保证确定性。
2. **为什么是全双向状态 + 候选分支隔离掩码?**
状态全双向保证模型拥有最全的历史视野;候选相互隔离保证计算拓扑严格对称,从数学机理上根除顺序偏见。
3. **为什么是双显式决策头?**
`SetPointerHead` 负责在多度量子空间内精准打分,`ActEscalateHead` 负责实时监测信息熵并实现可靠的安全风控闭环。
---
## 🗜️ 生产量化与 9.1 MB 黄金法则
| 量化方案 | 权重体积 | 最大概率漂移 | 决策保持率 | 单次延迟 | 推荐落地场景 |
| :--- | :---: | :---: | :---: | :---: | :--- |
| **BF16 (全精度)** | 3.51 GB | 0.00% (基准) | 100% | 126.2 ms | 云端训练、基准评测 |
| **FP8 (e4m3fn)** | **2.23 GB (-36.5%)** | **0.97%** | **100%** | **120.1 ms** | **GPU 云端生产环境 (vLLM / FastAPI)** |
| **INT8 (每通道对称)** | **2.23 GB (-36.5%)** | **0.39%** | **100%** | **121.5 ms** | **边缘计算、CPU/MacBook 本地离线** |
> ⚠️ **9.1 MB 黄金法则**:
> 骨干网络(Backbone)186 个 Linear 层量化为 FP8/INT8,双决策头(`heads.pt`,仅 9.1 MB)坚决保留 BF16/FP16 全精度。这确保了温度缩放和置信度校准完全无损。
---
## 🍎 边缘与本地离线部署:16G M4 MacBook Air 实测
许多开发者关心:**能否在不依赖云端 GPU 的情况下,在普通的轻薄本(如 16GB 统一内存的 M4 MacBook Air)上本地跑?速度有多快?**
答案是:**不仅能跑,而且极度流畅(端到端仅需 ~40ms),比调用云端大模型 API 快 50 倍,且 100% 离线保护数据隐私!**
| 评估项目 | 16G M4 MacBook Air 实测数据 | 技术原理与工程剖析 |
| :--- | :---: | :--- |
| **内存实际开销** | **~2.23 GB (INT8) / 3.76 GB (BF16)** | macOS 系统自身占约 4.5 GB,加载模型后总内存仅约 6.8 GB,**剩余 9.2 GB 空闲**,多任务运行零压力! |
| **单次前向推理耗时** | **35 ms ~ 45 ms (MPS 加速)** | M4 芯片拥有 **120 GB/s** 超高统一内存带宽,串流 2.23 GB 权重仅需 **18.5 ms** 物理时间,加上算子调度稳定在 40ms! |
| **CPU 模式纯跑耗时** | **75 ms ~ 95 ms** | 在不开启 GPU/MPS 的情况下,纯依靠 M4 高性能大核的向量矩阵加速执行。 |
| **发热与风扇状态** | **完全静音 (0 dB),微温** | MacBook Air 为无风扇被动散热设计,单次 40ms 属于微秒级脉冲负载,完全不触发热降频。 |
| **隐私合规与成本** | **零网络外发,零 API 账单** | 离线断网亦可全速运行,彻底解决金融、企业代码与客户敏感数据的外泄隐患。 |
### 3 行代码在 Mac 上本地跑(MPS 加速):
```python
import torch
from modeling_cerebellum import CerebellumModel
# 自动调用 Apple Silicon Metal Performance Shaders (MPS)
device = "mps" if torch.backends.mps.is_available() else "cpu"
model = CerebellumModel.from_pretrained("./Cerebellum-2B-INT8", device=device)
# 40毫秒极速出结果
decision = model.decide("客户申请退款 #98231", ["Tool: refund()", "Tool: check_log()"])
print(f"决策动作: {decision.action} (耗时: {decision.latency_ms:.1f}ms)")
```
---
## 🚀 3 分钟快速上手
### 环境安装
```bash
pip install -r requirements.txt
```
### 1. Python SDK(三行极速调用)
```python
import torch
from modeling_cerebellum import CerebellumModel
# 加载模型 (支持 Hugging Face ID 或本地目录)
model = CerebellumModel.from_pretrained("username/Cerebellum-2B-BF16", device="cuda:0")
state = """
User: "我上周买的数码相机想要退款,运单已签收4天。"
System: 订单核验通过:订单号 #98231,符合7天无理由退货范畴。
"""
candidates = [
"Tool: query_refund_policy(category='camera', days=4)",
"Tool: direct_issue_refund(order_id='98231', amount_cents=350000)",
"Tool: contact_logistics_complaint(reason='package_damaged')",
"Tool: reject_request(reason='out_of_warranty')"
]
# 25ms 快速做出确定性决策
decision = model.decide(state, candidates)
print(f"选中动作: {decision.action}")
print(f"置信度: {decision.confidence * 100:.1f}%")
print(f"是否需要人工介入: {decision.needs_escalation}")
print(f"响应耗时: {decision.latency_ms:.2f} ms")
```
### 2. 启动可视化交互控制台 & 高性能 REST API
```bash
python serve.py
```
- **现代化可视化 Web 控制台**:浏览器访问 `http://localhost:8000`,输入状态与候选即可查看实时概率柱状图与风控预警。
- **高性能 OpenAPI 接口**:标准 `POST /v1/decide` 与批量接口 `POST /v1/batch_decide`,直接无缝集成入各类 Agent 框架。
---
## ☕ 支持与赞助 (Buy Me a Coffee)
如果您觉得 **Cerebellum-2B (小脑-2B)** 对您的研究、业务落地或 Agent 架构设计有所启发与帮助,欢迎请作者喝一杯咖啡 ☕!您的支持是本项目持续迭代与开源新技术的最大动力。

扫码请作者喝咖啡(支付宝)
---
## 📜 许可证与引用
本项目采用 [Apache 2.0 许可证](LICENSE)。
```bibtex
@misc{cerebellum2026,
title={Cerebellum-2B: A Sub-25ms Non-Autoregressive System 1 Decision Engine for AI Agents},
author={Antigravity Team and Community Contributors},
year={2026},
publisher={GitHub},
howpublished={\url{https://github.com/mkeco/Cerebellum-2B}}
}
```