
Spaces:
Sleeping

Sleeping
Upload folder using huggingface_hub
Browse files- .gitignore +52 -0
- README.md +172 -7
- app.py +9 -0
- app/__init__.py +1 -0
- app/api.py +125 -0
- config.py +46 -0
- database.py +148 -0
- download_trashnet.py +44 -0
- knowledge.py +154 -0
- main.py +232 -0
- models/.gitkeep +0 -0
- models/evaluation_report.txt +26 -0
- models/garbage_model.pth +3 -0
- models/training_curves.png +0 -0
- predict.py +80 -0
- pyproject.toml +25 -0
- requirements.txt +11 -0
- split_dataset.py +83 -0
- train.py +388 -0
- uv.lock +0 -0
- webui.py +790 -0
.gitignore
ADDED
|
@@ -0,0 +1,52 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
# Python
|
| 2 |
+
__pycache__/
|
| 3 |
+
*.py[cod]
|
| 4 |
+
*.egg-info/
|
| 5 |
+
*.egg
|
| 6 |
+
dist/
|
| 7 |
+
build/
|
| 8 |
+
|
| 9 |
+
# Virtual environment
|
| 10 |
+
.venv/
|
| 11 |
+
venv/
|
| 12 |
+
env/
|
| 13 |
+
|
| 14 |
+
# Model files (HF Spaces needs .pth for deployment)
|
| 15 |
+
# Remove the # below to exclude from GitHub:
|
| 16 |
+
# models/*.pth
|
| 17 |
+
models/*.pt
|
| 18 |
+
!models/.gitkeep
|
| 19 |
+
|
| 20 |
+
# Database
|
| 21 |
+
*.db
|
| 22 |
+
*.sqlite
|
| 23 |
+
|
| 24 |
+
# Uploads
|
| 25 |
+
uploads/*
|
| 26 |
+
!uploads/.gitkeep
|
| 27 |
+
|
| 28 |
+
# Dataset (large, download separately)
|
| 29 |
+
dataset/trashnet/*
|
| 30 |
+
!dataset/trashnet/.gitkeep
|
| 31 |
+
dataset/train/*
|
| 32 |
+
!dataset/train/.gitkeep
|
| 33 |
+
dataset/val/*
|
| 34 |
+
!dataset/val/.gitkeep
|
| 35 |
+
dataset/test/*
|
| 36 |
+
!dataset/test/.gitkeep
|
| 37 |
+
|
| 38 |
+
# OS
|
| 39 |
+
.DS_Store
|
| 40 |
+
Thumbs.db
|
| 41 |
+
|
| 42 |
+
# IDE
|
| 43 |
+
.vscode/
|
| 44 |
+
.idea/
|
| 45 |
+
*.swp
|
| 46 |
+
*.swo
|
| 47 |
+
|
| 48 |
+
# trssssssshnet repo (separate clone)
|
| 49 |
+
trashnet/
|
| 50 |
+
|
| 51 |
+
# Temp
|
| 52 |
+
temp_upload.jpg
|
README.md
CHANGED
|
@@ -1,13 +1,178 @@
|
|
| 1 |
---
|
| 2 |
-
title:
|
| 3 |
-
emoji:
|
| 4 |
-
colorFrom:
|
| 5 |
-
colorTo:
|
| 6 |
sdk: gradio
|
| 7 |
-
sdk_version:
|
| 8 |
-
python_version: '3.13'
|
| 9 |
app_file: app.py
|
| 10 |
pinned: false
|
| 11 |
---
|
| 12 |
|
| 13 |
-
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
---
|
| 2 |
+
title: AI 垃圾分类助手
|
| 3 |
+
emoji: ♻️
|
| 4 |
+
colorFrom: green
|
| 5 |
+
colorTo: green
|
| 6 |
sdk: gradio
|
| 7 |
+
sdk_version: 5.0.0
|
|
|
|
| 8 |
app_file: app.py
|
| 9 |
pinned: false
|
| 10 |
---
|
| 11 |
|
| 12 |
+
# ♻️ AI 垃圾分类助手
|
| 13 |
+
|
| 14 |
+
基于深度学习的垃圾分类识别系统,支持 6 类垃圾(塑料、纸板、纸张、玻璃、金属、其他垃圾)的图像识别,并提供投放指南、环保积分和排行榜功能。
|
| 15 |
+
|
| 16 |
+
**[GitHub 仓库](https://github.com/hutiger9/garbage-classification)**
|
| 17 |
+
|
| 18 |
+
## 技术栈
|
| 19 |
+
|
| 20 |
+
| 模块 | 技术 |
|
| 21 |
+
|------|------|
|
| 22 |
+
| 深度学习框架 | PyTorch + torchvision |
|
| 23 |
+
| 模型架构 | MobileNetV3-Small(迁移学习,ImageNet 预训练) |
|
| 24 |
+
| 硬件加速 | Apple Silicon MPS / NVIDIA CUDA / CPU 自动切换 |
|
| 25 |
+
| Web 界面 | Gradio |
|
| 26 |
+
| REST API | FastAPI + uvicorn |
|
| 27 |
+
| 数据库 | SQLite(用户积分、分类记录) |
|
| 28 |
+
| 包管理 | uv / pip |
|
| 29 |
+
| 数据可视化 | Matplotlib(训练曲线) |
|
| 30 |
+
| 推理优化 | Top-K 置信度输出、混淆矩阵分析 |
|
| 31 |
+
|
| 32 |
+
## 项目结构
|
| 33 |
+
|
| 34 |
+
```
|
| 35 |
+
Garbage_classification/
|
| 36 |
+
├── main.py # CLI 入口(训练/预测/webui/api)
|
| 37 |
+
├── train.py # 模型训练 + 评估报告
|
| 38 |
+
├── predict.py # 推理预测
|
| 39 |
+
├── webui.py # Gradio 网页界面
|
| 40 |
+
├── app/
|
| 41 |
+
│ └── api.py # FastAPI REST 接口
|
| 42 |
+
├── config.py # 全局配置
|
| 43 |
+
├── database.py # SQLite 数据库
|
| 44 |
+
├── knowledge.py # 垃圾分类知识库
|
| 45 |
+
├── split_dataset.py # 数据集划分工具
|
| 46 |
+
├── download_trashnet.py # 数据集下载
|
| 47 |
+
├── models/ # 模型保存目录
|
| 48 |
+
├── dataset/ # 数据集目录
|
| 49 |
+
├── pyproject.toml # 项目配置
|
| 50 |
+
└── requirements.txt # 依赖列表
|
| 51 |
+
```
|
| 52 |
+
|
| 53 |
+
## 快速开始
|
| 54 |
+
|
| 55 |
+
### 1. 解压项目
|
| 56 |
+
|
| 57 |
+
```bash
|
| 58 |
+
unzip Garbage_classification.zip
|
| 59 |
+
cd Garbage_classification
|
| 60 |
+
```
|
| 61 |
+
|
| 62 |
+
### 2. 安装 Python 环境
|
| 63 |
+
|
| 64 |
+
**方式一:uv(推荐)**
|
| 65 |
+
|
| 66 |
+
```bash
|
| 67 |
+
# 安装 uv(如未安装)
|
| 68 |
+
curl -LsSf https://astral.sh/uv/install.sh | sh
|
| 69 |
+
|
| 70 |
+
# 创建虚拟环境并安装依赖
|
| 71 |
+
uv venv
|
| 72 |
+
uv sync
|
| 73 |
+
```
|
| 74 |
+
|
| 75 |
+
**方式二:pip**
|
| 76 |
+
|
| 77 |
+
```bash
|
| 78 |
+
python -m venv .venv
|
| 79 |
+
source .venv/bin/activate # Windows: .venv\Scripts\activate
|
| 80 |
+
pip install -r requirements.txt
|
| 81 |
+
```
|
| 82 |
+
|
| 83 |
+
### 3. 准备数据集
|
| 84 |
+
|
| 85 |
+
```bash
|
| 86 |
+
# 自动下载 TrashNet 数据集并划分训练集/验证集/测试集
|
| 87 |
+
python download_trashnet.py
|
| 88 |
+
```
|
| 89 |
+
|
| 90 |
+
或手动下载后将图片放入 `dataset/` 目录,运行:
|
| 91 |
+
|
| 92 |
+
```bash
|
| 93 |
+
python split_dataset.py
|
| 94 |
+
```
|
| 95 |
+
|
| 96 |
+
### 4. 训练模型
|
| 97 |
+
|
| 98 |
+
```bash
|
| 99 |
+
# 使用 uv
|
| 100 |
+
uv run python main.py train
|
| 101 |
+
|
| 102 |
+
# 或使用 pip 虚拟环境
|
| 103 |
+
python main.py train
|
| 104 |
+
```
|
| 105 |
+
|
| 106 |
+
训练完成后会在 `models/` 目录生成:
|
| 107 |
+
- `garbage_model.pth` — 最佳模型权重
|
| 108 |
+
- `training_curves.png` — 训练 Loss/Accuracy 曲线图
|
| 109 |
+
- `evaluation_report.txt` — 详细评估报告(各类别准确率 + 混淆矩阵)
|
| 110 |
+
|
| 111 |
+
### 5. 启动 Web 界面
|
| 112 |
+
|
| 113 |
+
```bash
|
| 114 |
+
uv run python main.py webui
|
| 115 |
+
```
|
| 116 |
+
|
| 117 |
+
打开浏览器访问 `http://localhost:7860`
|
| 118 |
+
|
| 119 |
+
### 6. 启动 API 服务(可选,供小程序调用)
|
| 120 |
+
|
| 121 |
+
```bash
|
| 122 |
+
uv run python main.py api
|
| 123 |
+
```
|
| 124 |
+
|
| 125 |
+
API 文档访问 `http://localhost:8000/docs`
|
| 126 |
+
|
| 127 |
+
## 支持的垃圾类别
|
| 128 |
+
|
| 129 |
+
| 类别 | 英文 | 举例 |
|
| 130 |
+
|------|------|------|
|
| 131 |
+
| 🥤 塑料 | plastic | 饮料瓶、塑料袋、塑料容器 |
|
| 132 |
+
| 📦 纸板 | cardboard | 快递纸箱、包装盒 |
|
| 133 |
+
| 📄 纸张 | paper | 办公用纸、报纸、杂志 |
|
| 134 |
+
| 🍾 玻璃 | glass | 玻璃瓶、玻璃制品 |
|
| 135 |
+
| 🥫 金属 | metal | 易拉罐、金属罐、铁盒 |
|
| 136 |
+
| 🍂 其他垃圾 | trash | 杂物、不可回收物 |
|
| 137 |
+
|
| 138 |
+
## 模型性能
|
| 139 |
+
|
| 140 |
+
在 TrashNet 测试集上(基于 MobileNetV3-Small):
|
| 141 |
+
|
| 142 |
+
| 类别 | 准确率 |
|
| 143 |
+
|------|--------|
|
| 144 |
+
| 纸板 | 96.77% |
|
| 145 |
+
| 纸张 | 96.67% |
|
| 146 |
+
| 金属 | 93.65% |
|
| 147 |
+
| 塑料 | 91.67% |
|
| 148 |
+
| 玻璃 | 90.79% |
|
| 149 |
+
| 其他垃圾 | 77.27% |
|
| 150 |
+
| **总体** | **92.99%** |
|
| 151 |
+
|
| 152 |
+
## CLI 命令
|
| 153 |
+
|
| 154 |
+
```bash
|
| 155 |
+
# 训练模型
|
| 156 |
+
python main.py train
|
| 157 |
+
|
| 158 |
+
# 预测单张图片
|
| 159 |
+
python main.py predict <图片路径>
|
| 160 |
+
|
| 161 |
+
# 查询垃圾分类知识
|
| 162 |
+
python main.py query <垃圾名称>
|
| 163 |
+
|
| 164 |
+
# 查看用户环保记录
|
| 165 |
+
python main.py record <用户名>
|
| 166 |
+
|
| 167 |
+
# 查看用户统计
|
| 168 |
+
python main.py stats <用户名>
|
| 169 |
+
|
| 170 |
+
# 查看排行榜
|
| 171 |
+
python main.py leaderboard
|
| 172 |
+
|
| 173 |
+
# 启动 Web 界面
|
| 174 |
+
python main.py webui
|
| 175 |
+
|
| 176 |
+
# 启动 API 服务
|
| 177 |
+
python main.py api
|
| 178 |
+
```
|
app.py
ADDED
|
@@ -0,0 +1,9 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
Hugging Face Spaces 入口文件
|
| 3 |
+
自动加载 webui.py 中的 Gradio demo
|
| 4 |
+
"""
|
| 5 |
+
|
| 6 |
+
from webui import demo
|
| 7 |
+
|
| 8 |
+
# Gradio SDK 会自动调用 demo.launch()
|
| 9 |
+
# 这里只需导出 demo 对象即可
|
app/__init__.py
ADDED
|
@@ -0,0 +1 @@
|
|
|
|
|
|
|
| 1 |
+
"""AI 垃圾分类助手 - Web API"""
|
app/api.py
ADDED
|
@@ -0,0 +1,125 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
AI 垃圾分类助手 - Web API (FastAPI)
|
| 3 |
+
为小程序提供后端服务接口
|
| 4 |
+
"""
|
| 5 |
+
|
| 6 |
+
from fastapi import FastAPI, UploadFile, File, Form, HTTPException
|
| 7 |
+
from fastapi.middleware.cors import CORSMiddleware
|
| 8 |
+
import uvicorn
|
| 9 |
+
|
| 10 |
+
from predict import GarbageClassifier
|
| 11 |
+
from knowledge import get_class_info, search_knowledge, KNOWLEDGE_BASE
|
| 12 |
+
from database import Database
|
| 13 |
+
from config import UPLOAD_DIR
|
| 14 |
+
|
| 15 |
+
app = FastAPI(title="AI 垃圾分类助手", version="1.0.0")
|
| 16 |
+
app.add_middleware(CORSMiddleware, allow_origins=["*"], allow_methods=["*"], allow_headers=["*"])
|
| 17 |
+
|
| 18 |
+
classifier = None
|
| 19 |
+
db = Database()
|
| 20 |
+
|
| 21 |
+
UPLOAD_DIR.mkdir(exist_ok=True)
|
| 22 |
+
|
| 23 |
+
|
| 24 |
+
def get_classifier():
|
| 25 |
+
global classifier
|
| 26 |
+
if classifier is None:
|
| 27 |
+
classifier = GarbageClassifier()
|
| 28 |
+
return classifier
|
| 29 |
+
|
| 30 |
+
|
| 31 |
+
@app.get("/")
|
| 32 |
+
def root():
|
| 33 |
+
return {"message": "AI 垃圾分类助手 API", "version": "1.0.0"}
|
| 34 |
+
|
| 35 |
+
|
| 36 |
+
@app.post("/predict")
|
| 37 |
+
async def predict(file: UploadFile = File(...), username: str = Form("default")):
|
| 38 |
+
"""上传图片并分类"""
|
| 39 |
+
image_path = UPLOAD_DIR / file.filename
|
| 40 |
+
content = await file.read()
|
| 41 |
+
with open(image_path, "wb") as f:
|
| 42 |
+
f.write(content)
|
| 43 |
+
|
| 44 |
+
clf = get_classifier()
|
| 45 |
+
results = clf.predict(str(image_path))
|
| 46 |
+
best = results[0]
|
| 47 |
+
|
| 48 |
+
user_id = db.register_user(username)
|
| 49 |
+
points = db.add_record(user_id, best["class_name"], best["confidence"], str(image_path))
|
| 50 |
+
|
| 51 |
+
info = get_class_info(best["class_name"])
|
| 52 |
+
return {"success": True, "results": results, "points_earned": points, "knowledge": info}
|
| 53 |
+
|
| 54 |
+
|
| 55 |
+
@app.get("/predict_url")
|
| 56 |
+
def predict_url(image_url: str, username: str = "default"):
|
| 57 |
+
"""通过 URL 识别图片"""
|
| 58 |
+
import requests
|
| 59 |
+
from PIL import Image
|
| 60 |
+
import io
|
| 61 |
+
|
| 62 |
+
response = requests.get(image_url, timeout=10)
|
| 63 |
+
image = Image.open(io.BytesIO(response.content)).convert("RGB")
|
| 64 |
+
|
| 65 |
+
temp_path = UPLOAD_DIR / "url_temp.jpg"
|
| 66 |
+
image.save(temp_path)
|
| 67 |
+
|
| 68 |
+
clf = get_classifier()
|
| 69 |
+
results = clf.predict(str(temp_path))
|
| 70 |
+
best = results[0]
|
| 71 |
+
|
| 72 |
+
user_id = db.register_user(username)
|
| 73 |
+
points = db.add_record(user_id, best["class_name"], best["confidence"], image_url)
|
| 74 |
+
|
| 75 |
+
info = get_class_info(best["class_name"])
|
| 76 |
+
return {"success": True, "results": results, "points_earned": points, "knowledge": info}
|
| 77 |
+
|
| 78 |
+
|
| 79 |
+
@app.get("/knowledge/{class_name}")
|
| 80 |
+
def get_knowledge(class_name: str):
|
| 81 |
+
info = get_class_info(class_name)
|
| 82 |
+
if not info:
|
| 83 |
+
raise HTTPException(status_code=404, detail="未找到该类别信息")
|
| 84 |
+
return info
|
| 85 |
+
|
| 86 |
+
|
| 87 |
+
@app.get("/knowledge")
|
| 88 |
+
def search_knowledge_api(q: str = ""):
|
| 89 |
+
if q:
|
| 90 |
+
return {k: v for k, v in search_knowledge(q)}
|
| 91 |
+
return KNOWLEDGE_BASE
|
| 92 |
+
|
| 93 |
+
|
| 94 |
+
@app.post("/user/register")
|
| 95 |
+
def register_user(username: str = Form(...)):
|
| 96 |
+
user_id = db.register_user(username)
|
| 97 |
+
return {"user_id": user_id, "username": username}
|
| 98 |
+
|
| 99 |
+
|
| 100 |
+
@app.get("/user/{username}/stats")
|
| 101 |
+
def user_stats(username: str):
|
| 102 |
+
user = db.get_user(username)
|
| 103 |
+
if not user:
|
| 104 |
+
raise HTTPException(status_code=404, detail="用户不存在")
|
| 105 |
+
return db.get_user_stats(user["id"])
|
| 106 |
+
|
| 107 |
+
|
| 108 |
+
@app.get("/leaderboard")
|
| 109 |
+
def leaderboard(limit: int = 10):
|
| 110 |
+
return {"leaderboard": db.get_leaderboard(limit)}
|
| 111 |
+
|
| 112 |
+
|
| 113 |
+
def start_api(host="0.0.0.0", port=8000):
|
| 114 |
+
print(f"🌐 API 服务已启动: http://localhost:{port}")
|
| 115 |
+
print(f" POST /predict # 上传图片分类")
|
| 116 |
+
print(f" GET /predict_url # URL 图片分类")
|
| 117 |
+
print(f" GET /knowledge # 查询知识库")
|
| 118 |
+
print(f" POST /user/register # 注册用户")
|
| 119 |
+
print(f" GET /user/{{name}}/stats # 用户统计")
|
| 120 |
+
print(f" GET /leaderboard # 排行榜")
|
| 121 |
+
uvicorn.run(app, host=host, port=port)
|
| 122 |
+
|
| 123 |
+
|
| 124 |
+
if __name__ == "__main__":
|
| 125 |
+
start_api()
|
config.py
ADDED
|
@@ -0,0 +1,46 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
AI 垃圾分类助手 - 全局配置
|
| 3 |
+
集中管理路径和参数
|
| 4 |
+
"""
|
| 5 |
+
|
| 6 |
+
from pathlib import Path
|
| 7 |
+
|
| 8 |
+
# 项目根目录
|
| 9 |
+
ROOT = Path(__file__).parent
|
| 10 |
+
|
| 11 |
+
# 原始数据集 (手动下载)
|
| 12 |
+
RAW_DATASET_DIR = ROOT / "dataset" / "trashnet"
|
| 13 |
+
|
| 14 |
+
# 划分后的数据集 (split_dataset.py 生成)
|
| 15 |
+
DATASET_DIR = ROOT / "dataset"
|
| 16 |
+
TRAIN_DIR = DATASET_DIR / "train"
|
| 17 |
+
VAL_DIR = DATASET_DIR / "val"
|
| 18 |
+
TEST_DIR = DATASET_DIR / "test"
|
| 19 |
+
|
| 20 |
+
# 模型
|
| 21 |
+
MODEL_DIR = ROOT / "models"
|
| 22 |
+
MODEL_PATH = MODEL_DIR / "garbage_model.pth"
|
| 23 |
+
|
| 24 |
+
# 上传目录 (API)
|
| 25 |
+
UPLOAD_DIR = ROOT / "uploads"
|
| 26 |
+
|
| 27 |
+
# 数据库
|
| 28 |
+
DB_PATH = ROOT / "garbage_assistant.db"
|
| 29 |
+
|
| 30 |
+
# TrashNet 类别 (6类)
|
| 31 |
+
CLASS_NAMES = ["cardboard", "glass", "metal", "paper", "plastic", "trash"]
|
| 32 |
+
CLASS_NAMES_CN = ["纸板", "玻璃", "金属", "纸张", "塑料", "其他垃圾"]
|
| 33 |
+
|
| 34 |
+
# 训练参数
|
| 35 |
+
TRAIN_PARAMS = {
|
| 36 |
+
"epochs": 30,
|
| 37 |
+
"batch_size": 32,
|
| 38 |
+
"lr": 0.001,
|
| 39 |
+
"input_size": 224,
|
| 40 |
+
"resize_size": 256,
|
| 41 |
+
}
|
| 42 |
+
|
| 43 |
+
# 推理参数
|
| 44 |
+
INFER_PARAMS = {
|
| 45 |
+
"top_k": 3,
|
| 46 |
+
}
|
database.py
ADDED
|
@@ -0,0 +1,148 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
AI 垃圾分类助手 - 数据库模块
|
| 3 |
+
使用 SQLite 记录用户分类历史和环保积分
|
| 4 |
+
"""
|
| 5 |
+
|
| 6 |
+
import sqlite3
|
| 7 |
+
from datetime import date
|
| 8 |
+
|
| 9 |
+
|
| 10 |
+
class Database:
|
| 11 |
+
def __init__(self, db_path="garbage_assistant.db"):
|
| 12 |
+
self.db_path = db_path
|
| 13 |
+
self.init_database()
|
| 14 |
+
|
| 15 |
+
def _get_conn(self):
|
| 16 |
+
conn = sqlite3.connect(self.db_path)
|
| 17 |
+
conn.row_factory = sqlite3.Row
|
| 18 |
+
conn.execute("PRAGMA journal_mode=WAL")
|
| 19 |
+
return conn
|
| 20 |
+
|
| 21 |
+
def init_database(self):
|
| 22 |
+
conn = self._get_conn()
|
| 23 |
+
conn.executescript("""
|
| 24 |
+
CREATE TABLE IF NOT EXISTS users (
|
| 25 |
+
id INTEGER PRIMARY KEY AUTOINCREMENT,
|
| 26 |
+
username TEXT UNIQUE NOT NULL,
|
| 27 |
+
total_points INTEGER DEFAULT 0,
|
| 28 |
+
total_classifications INTEGER DEFAULT 0,
|
| 29 |
+
created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
|
| 30 |
+
);
|
| 31 |
+
|
| 32 |
+
CREATE TABLE IF NOT EXISTS records (
|
| 33 |
+
id INTEGER PRIMARY KEY AUTOINCREMENT,
|
| 34 |
+
user_id INTEGER NOT NULL,
|
| 35 |
+
image_path TEXT,
|
| 36 |
+
predicted_class TEXT NOT NULL,
|
| 37 |
+
confidence REAL,
|
| 38 |
+
points INTEGER DEFAULT 10,
|
| 39 |
+
created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
|
| 40 |
+
FOREIGN KEY (user_id) REFERENCES users(id)
|
| 41 |
+
);
|
| 42 |
+
|
| 43 |
+
CREATE TABLE IF NOT EXISTS daily_stats (
|
| 44 |
+
id INTEGER PRIMARY KEY AUTOINCREMENT,
|
| 45 |
+
user_id INTEGER NOT NULL,
|
| 46 |
+
date TEXT NOT NULL,
|
| 47 |
+
count INTEGER DEFAULT 0,
|
| 48 |
+
points INTEGER DEFAULT 0,
|
| 49 |
+
FOREIGN KEY (user_id) REFERENCES users(id),
|
| 50 |
+
UNIQUE(user_id, date)
|
| 51 |
+
);
|
| 52 |
+
""")
|
| 53 |
+
conn.commit()
|
| 54 |
+
conn.close()
|
| 55 |
+
|
| 56 |
+
def register_user(self, username):
|
| 57 |
+
conn = self._get_conn()
|
| 58 |
+
try:
|
| 59 |
+
cursor = conn.cursor()
|
| 60 |
+
cursor.execute("INSERT INTO users (username) VALUES (?)", (username,))
|
| 61 |
+
conn.commit()
|
| 62 |
+
user_id = cursor.lastrowid
|
| 63 |
+
print(f"✓ 用户 '{username}' 注册成功 (ID: {user_id})")
|
| 64 |
+
return user_id
|
| 65 |
+
except sqlite3.IntegrityError:
|
| 66 |
+
user_id = conn.execute(
|
| 67 |
+
"SELECT id FROM users WHERE username = ?", (username,)
|
| 68 |
+
).fetchone()["id"]
|
| 69 |
+
print(f"ℹ 用户 '{username}' 已存在 (ID: {user_id})")
|
| 70 |
+
return user_id
|
| 71 |
+
finally:
|
| 72 |
+
conn.close()
|
| 73 |
+
|
| 74 |
+
def get_user(self, username):
|
| 75 |
+
conn = self._get_conn()
|
| 76 |
+
user = conn.execute(
|
| 77 |
+
"SELECT * FROM users WHERE username = ?", (username,)
|
| 78 |
+
).fetchone()
|
| 79 |
+
conn.close()
|
| 80 |
+
return dict(user) if user else None
|
| 81 |
+
|
| 82 |
+
def add_record(self, user_id, predicted_class, confidence, image_path=None):
|
| 83 |
+
today = date.today().isoformat()
|
| 84 |
+
points = max(5, min(20, int(confidence * 20)))
|
| 85 |
+
|
| 86 |
+
conn = self._get_conn()
|
| 87 |
+
conn.execute(
|
| 88 |
+
"INSERT INTO records (user_id, image_path, predicted_class, confidence, points) VALUES (?, ?, ?, ?, ?)",
|
| 89 |
+
(user_id, image_path, predicted_class, confidence, points),
|
| 90 |
+
)
|
| 91 |
+
conn.execute(
|
| 92 |
+
"UPDATE users SET total_points = total_points + ?, total_classifications = total_classifications + 1 WHERE id = ?",
|
| 93 |
+
(points, user_id),
|
| 94 |
+
)
|
| 95 |
+
conn.execute(
|
| 96 |
+
"INSERT INTO daily_stats (user_id, date, count, points) VALUES (?, ?, 1, ?) "
|
| 97 |
+
"ON CONFLICT(user_id, date) DO UPDATE SET count = count + 1, points = points + ?",
|
| 98 |
+
(user_id, today, points, points),
|
| 99 |
+
)
|
| 100 |
+
conn.commit()
|
| 101 |
+
conn.close()
|
| 102 |
+
return points
|
| 103 |
+
|
| 104 |
+
def get_user_stats(self, user_id):
|
| 105 |
+
conn = self._get_conn()
|
| 106 |
+
user = conn.execute("SELECT * FROM users WHERE id = ?", (user_id,)).fetchone()
|
| 107 |
+
if not user:
|
| 108 |
+
conn.close()
|
| 109 |
+
return None
|
| 110 |
+
|
| 111 |
+
stats = dict(user)
|
| 112 |
+
stats["recent_records"] = [
|
| 113 |
+
dict(r) for r in conn.execute(
|
| 114 |
+
"SELECT predicted_class, confidence, points, created_at FROM records WHERE user_id = ? ORDER BY created_at DESC LIMIT 10",
|
| 115 |
+
(user_id,),
|
| 116 |
+
).fetchall()
|
| 117 |
+
]
|
| 118 |
+
stats["class_distribution"] = [
|
| 119 |
+
dict(r) for r in conn.execute(
|
| 120 |
+
"SELECT predicted_class, COUNT(*) as count FROM records WHERE user_id = ? GROUP BY predicted_class ORDER BY count DESC",
|
| 121 |
+
(user_id,),
|
| 122 |
+
).fetchall()
|
| 123 |
+
]
|
| 124 |
+
|
| 125 |
+
today = date.today().isoformat()
|
| 126 |
+
today_row = conn.execute(
|
| 127 |
+
"SELECT * FROM daily_stats WHERE user_id = ? AND date = ?", (user_id, today)
|
| 128 |
+
).fetchone()
|
| 129 |
+
stats["today"] = dict(today_row) if today_row else {"count": 0, "points": 0}
|
| 130 |
+
|
| 131 |
+
stats["weekly"] = [
|
| 132 |
+
dict(r) for r in conn.execute(
|
| 133 |
+
"SELECT date, count, points FROM daily_stats WHERE user_id = ? AND date >= date('now', '-7 days') ORDER BY date DESC",
|
| 134 |
+
(user_id,),
|
| 135 |
+
).fetchall()
|
| 136 |
+
]
|
| 137 |
+
|
| 138 |
+
conn.close()
|
| 139 |
+
return stats
|
| 140 |
+
|
| 141 |
+
def get_leaderboard(self, limit=10):
|
| 142 |
+
conn = self._get_conn()
|
| 143 |
+
leaders = conn.execute(
|
| 144 |
+
"SELECT username, total_points, total_classifications FROM users ORDER BY total_points DESC LIMIT ?",
|
| 145 |
+
(limit,),
|
| 146 |
+
).fetchall()
|
| 147 |
+
conn.close()
|
| 148 |
+
return [dict(r) for r in leaders]
|
download_trashnet.py
ADDED
|
@@ -0,0 +1,44 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""下载 TrashNet 数据集并整理为 ImageFolder 格式"""
|
| 2 |
+
from datasets import load_dataset
|
| 3 |
+
from pathlib import Path
|
| 4 |
+
import argparse
|
| 5 |
+
|
| 6 |
+
CLASS_NAMES = ["cardboard", "glass", "metal", "paper", "plastic", "trash"]
|
| 7 |
+
|
| 8 |
+
def download_trashnet(output_dir="dataset/trashnet"):
|
| 9 |
+
out = Path(output_dir)
|
| 10 |
+
out.mkdir(parents=True, exist_ok=True)
|
| 11 |
+
|
| 12 |
+
print("正在从 Hugging Face 下载 TrashNet 数据集...")
|
| 13 |
+
ds = load_dataset("garythung/trashnet", split="train", trust_remote_code=True)
|
| 14 |
+
|
| 15 |
+
label_names = ds.features["label"].names
|
| 16 |
+
print(f"类别: {label_names}")
|
| 17 |
+
print(f"总样本数: {len(ds)}")
|
| 18 |
+
|
| 19 |
+
# 为每个类别创建子目录
|
| 20 |
+
for name in label_names:
|
| 21 |
+
(out / name).mkdir(exist_ok=True)
|
| 22 |
+
|
| 23 |
+
# 逐条保存
|
| 24 |
+
for i, sample in enumerate(ds):
|
| 25 |
+
label = label_names[sample["label"]]
|
| 26 |
+
img = sample["image"]
|
| 27 |
+
ext = "png" if img.mode == "RGBA" else "jpg"
|
| 28 |
+
save_path = out / label / f"{label}_{i:05d}.{ext}"
|
| 29 |
+
img = img.convert("RGB")
|
| 30 |
+
img.save(save_path)
|
| 31 |
+
if (i + 1) % 500 == 0:
|
| 32 |
+
print(f" 已保存 {i + 1}/{len(ds)} 张...")
|
| 33 |
+
|
| 34 |
+
# 打印统计
|
| 35 |
+
print("\n下载完成!数据集统计:")
|
| 36 |
+
for name in label_names:
|
| 37 |
+
count = len(list((out / name).iterdir()))
|
| 38 |
+
print(f" {name}: {count} 张")
|
| 39 |
+
|
| 40 |
+
if __name__ == "__main__":
|
| 41 |
+
parser = argparse.ArgumentParser()
|
| 42 |
+
parser.add_argument("--output-dir", default="dataset/trashnet")
|
| 43 |
+
args = parser.parse_args()
|
| 44 |
+
download_trashnet(args.output_dir)
|
knowledge.py
ADDED
|
@@ -0,0 +1,154 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
AI 垃圾分类助手 - 知识库模块
|
| 3 |
+
提供各类垃圾的投放指南、注意事项和环保知识
|
| 4 |
+
"""
|
| 5 |
+
|
| 6 |
+
KNOWLEDGE_BASE = {
|
| 7 |
+
"cardboard": {
|
| 8 |
+
"name_cn": "纸板/纸箱",
|
| 9 |
+
"category": "可回收物",
|
| 10 |
+
"description": "纸板属于可回收物,包括快递纸箱、包装纸盒、纸板箱等。",
|
| 11 |
+
"disposal": (
|
| 12 |
+
"1. 清空内容物,去除胶带和标签\n"
|
| 13 |
+
"2. 压平折叠,减小体积\n"
|
| 14 |
+
"3. 保持干燥清洁,避免油污污染\n"
|
| 15 |
+
"4. 绑扎整齐后投入可回收物收集容器"
|
| 16 |
+
),
|
| 17 |
+
"tips": [
|
| 18 |
+
"沾有油污的纸板属于其他垃圾,不可回收",
|
| 19 |
+
"纸板上的塑料胶带需要撕掉",
|
| 20 |
+
"淋湿的纸板回收价值降低,尽量保持干燥",
|
| 21 |
+
"大型纸板箱应拆开压平后再投放",
|
| 22 |
+
],
|
| 23 |
+
"fun_fact": "回收1吨废纸板可造好纸约800公斤,少砍17棵树!",
|
| 24 |
+
"degradation_time": "约3-4个月(自然降解)",
|
| 25 |
+
},
|
| 26 |
+
"glass": {
|
| 27 |
+
"name_cn": "玻璃",
|
| 28 |
+
"category": "可回收物",
|
| 29 |
+
"description": "玻璃制品属于可回收物,包括玻璃瓶、玻璃杯、玻璃碎片等。",
|
| 30 |
+
"disposal": (
|
| 31 |
+
"1. 清空残留物,用清水冲洗干净\n"
|
| 32 |
+
"2. 去掉瓶盖和金属环\n"
|
| 33 |
+
"3. 建议用纸包好后再投放,防止破碎伤人\n"
|
| 34 |
+
"4. 投入可回收物收集容器"
|
| 35 |
+
),
|
| 36 |
+
"tips": [
|
| 37 |
+
"碎玻璃应用厚纸包好后再投放,并标注小心玻璃",
|
| 38 |
+
"灯泡、镜子属于其他垃圾(部分为有害垃圾)",
|
| 39 |
+
"玻璃瓶的金属瓶盖需分离投放",
|
| 40 |
+
"耐热玻璃和普通玻璃应分开回收(处理温度不同)",
|
| 41 |
+
],
|
| 42 |
+
"fun_fact": "玻璃可以100%无限次循环利用,且质量不会下降!",
|
| 43 |
+
"degradation_time": "约100万年(自然降解)",
|
| 44 |
+
},
|
| 45 |
+
"plastic": {
|
| 46 |
+
"name_cn": "塑料",
|
| 47 |
+
"category": "可回收物",
|
| 48 |
+
"description": "塑料制品属于可回收物,包括塑料瓶、塑料桶、塑料包装等。",
|
| 49 |
+
"disposal": (
|
| 50 |
+
"1. 清空内容物,压扁瓶体\n"
|
| 51 |
+
"2. 取下瓶盖(瓶盖和瓶身材质不同,需分类)\n"
|
| 52 |
+
"3. 冲洗干净,去除残留\n"
|
| 53 |
+
"4. 投入可回收物收集容器"
|
| 54 |
+
),
|
| 55 |
+
"tips": [
|
| 56 |
+
"饮料瓶需要把水倒空再投放",
|
| 57 |
+
"塑料袋、塑料膜也可以回收",
|
| 58 |
+
"一次性塑料餐具如果污染严重属于其他垃圾",
|
| 59 |
+
"化妆品瓶需要清洗干净才能回收",
|
| 60 |
+
],
|
| 61 |
+
"fun_fact": "一个塑料瓶需要450年才能降解,回收是最好的选择!",
|
| 62 |
+
"degradation_time": "约200-500年(自然降解)",
|
| 63 |
+
},
|
| 64 |
+
"metal": {
|
| 65 |
+
"name_cn": "金属",
|
| 66 |
+
"category": "可回收物",
|
| 67 |
+
"description": "金属制品属于可回收物,包括易拉罐、金属罐、金属工具等。",
|
| 68 |
+
"disposal": (
|
| 69 |
+
"1. 清空内容物,冲洗干净\n"
|
| 70 |
+
"2. 易拉罐应压扁以减少体积\n"
|
| 71 |
+
"3. 喷雾罐需确认完全排空\n"
|
| 72 |
+
"4. 投入可回收物收集容器"
|
| 73 |
+
),
|
| 74 |
+
"tips": [
|
| 75 |
+
"易拉罐压扁后投放,节省空间",
|
| 76 |
+
"金属瓶盖可单独投放或和金属一起放",
|
| 77 |
+
"废弃的小件金属可直接投放",
|
| 78 |
+
"大型金属制品应联系废品回收站",
|
| 79 |
+
],
|
| 80 |
+
"fun_fact": "回收1个铝罐节省的电量可让电视运行3小时!",
|
| 81 |
+
"degradation_time": "约50-200年(自然降解)",
|
| 82 |
+
},
|
| 83 |
+
"paper": {
|
| 84 |
+
"name_cn": "纸张",
|
| 85 |
+
"category": "可回收物",
|
| 86 |
+
"description": "纸张属于可回收物,包括报纸、书籍、笔记本、办公用纸等。",
|
| 87 |
+
"disposal": (
|
| 88 |
+
"1. 去除订书钉、胶带等非纸附件\n"
|
| 89 |
+
"2. 尽量保持平整,不要揉成团\n"
|
| 90 |
+
"3. 保持干燥清洁\n"
|
| 91 |
+
"4. 投入可回收物收集容器"
|
| 92 |
+
),
|
| 93 |
+
"tips": [
|
| 94 |
+
"纸巾、卫生纸属于其他垃圾(水溶性太强)",
|
| 95 |
+
"照片纸不属于可回收纸张",
|
| 96 |
+
"复写纸、蜡纸属于其他垃圾",
|
| 97 |
+
"碎纸机处理后的纸张仍可回收",
|
| 98 |
+
],
|
| 99 |
+
"fun_fact": "回收1吨废纸可造好纸约800公斤,节省木材约3立方米!",
|
| 100 |
+
"degradation_time": "约2-6个月(自然降解)",
|
| 101 |
+
},
|
| 102 |
+
"trash": {
|
| 103 |
+
"name_cn": "其他垃圾/厨余",
|
| 104 |
+
"category": "其他垃圾",
|
| 105 |
+
"description": "包括食品残渣、果皮、纸巾、一次性餐具等不属于以上类别的垃圾。",
|
| 106 |
+
"disposal": (
|
| 107 |
+
"1. 沥干水分后投放\n"
|
| 108 |
+
"2. 用垃圾袋装好,扎紧袋口\n"
|
| 109 |
+
"3. 投入其他垃圾收集容器\n"
|
| 110 |
+
"4. 避免混入可回收物和有害垃圾"
|
| 111 |
+
),
|
| 112 |
+
"tips": [
|
| 113 |
+
"厨余垃圾应沥干水分后再投放",
|
| 114 |
+
"大骨头、贝壳属于其他垃圾(不易粉碎)",
|
| 115 |
+
"电池、药品等有害垃圾不可投入此桶",
|
| 116 |
+
"尽量减少厨余浪费,按需购买食材",
|
| 117 |
+
],
|
| 118 |
+
"fun_fact": "中国每年产生约1.5亿吨厨余垃圾,减少浪费从你我做起!",
|
| 119 |
+
"degradation_time": "约2-6周(自然降解)",
|
| 120 |
+
},
|
| 121 |
+
}
|
| 122 |
+
|
| 123 |
+
EN_TO_CN = {k: v["name_cn"] for k, v in KNOWLEDGE_BASE.items()}
|
| 124 |
+
|
| 125 |
+
|
| 126 |
+
def get_class_info(class_name):
|
| 127 |
+
"""获取指定类别的知识信息"""
|
| 128 |
+
return KNOWLEDGE_BASE.get(class_name)
|
| 129 |
+
|
| 130 |
+
|
| 131 |
+
def get_all_classes():
|
| 132 |
+
"""获取所有垃圾类别列表"""
|
| 133 |
+
return list(KNOWLEDGE_BASE.keys())
|
| 134 |
+
|
| 135 |
+
|
| 136 |
+
def search_knowledge(keyword):
|
| 137 |
+
"""搜索相关知识"""
|
| 138 |
+
kw = keyword.lower()
|
| 139 |
+
return [
|
| 140 |
+
(k, v) for k, v in KNOWLEDGE_BASE.items()
|
| 141 |
+
if kw in k or kw in v["name_cn"].lower()
|
| 142 |
+
]
|
| 143 |
+
|
| 144 |
+
|
| 145 |
+
def get_classification_guide():
|
| 146 |
+
"""获取简洁的分类指南"""
|
| 147 |
+
return {
|
| 148 |
+
k: {
|
| 149 |
+
"name_cn": v["name_cn"],
|
| 150 |
+
"category": v["category"],
|
| 151 |
+
"summary": v["description"],
|
| 152 |
+
}
|
| 153 |
+
for k, v in KNOWLEDGE_BASE.items()
|
| 154 |
+
}
|
main.py
ADDED
|
@@ -0,0 +1,232 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
#!/usr/bin/env python3
|
| 2 |
+
"""
|
| 3 |
+
AI 垃圾分类助手 - 环保小能手
|
| 4 |
+
主入口程序 (CLI)
|
| 5 |
+
"""
|
| 6 |
+
|
| 7 |
+
import argparse
|
| 8 |
+
from pathlib import Path
|
| 9 |
+
from config import DATASET_DIR, MODEL_DIR, MODEL_PATH
|
| 10 |
+
|
| 11 |
+
|
| 12 |
+
def cmd_train(args):
|
| 13 |
+
from train import train
|
| 14 |
+
train(args)
|
| 15 |
+
|
| 16 |
+
|
| 17 |
+
def cmd_predict(args):
|
| 18 |
+
from predict import GarbageClassifier
|
| 19 |
+
from knowledge import get_class_info
|
| 20 |
+
|
| 21 |
+
classifier = GarbageClassifier(model_path=args.model_path)
|
| 22 |
+
image_path = Path(args.image)
|
| 23 |
+
if not image_path.exists():
|
| 24 |
+
print(f"✗ 图片不存在: {image_path}")
|
| 25 |
+
return
|
| 26 |
+
|
| 27 |
+
print(f"正在识别: {image_path.name}")
|
| 28 |
+
results = classifier.predict(str(image_path), top_k=args.top_k)
|
| 29 |
+
|
| 30 |
+
print(f"\n{'='*40}")
|
| 31 |
+
print("识别结果:")
|
| 32 |
+
print(f"{'='*40}")
|
| 33 |
+
for i, r in enumerate(results, 1):
|
| 34 |
+
pct = r["confidence"] * 100
|
| 35 |
+
bar = "█" * int(pct // 5) + "░" * (20 - int(pct // 5))
|
| 36 |
+
print(f" {i}. [{bar}] {r['class_name_cn']} ({pct:.1f}%)")
|
| 37 |
+
|
| 38 |
+
if args.detail:
|
| 39 |
+
info = get_class_info(results[0]["class_name"])
|
| 40 |
+
if info:
|
| 41 |
+
print(f"\n{'='*40}")
|
| 42 |
+
print(f"垃圾分类指南 - {info['name_cn']}")
|
| 43 |
+
print(f"分类: {info['category']}")
|
| 44 |
+
print(f"{'='*40}")
|
| 45 |
+
print(info["disposal"])
|
| 46 |
+
print(f"\n💡 {info['fun_fact']}")
|
| 47 |
+
|
| 48 |
+
|
| 49 |
+
def cmd_query(args):
|
| 50 |
+
from knowledge import search_knowledge
|
| 51 |
+
|
| 52 |
+
results = search_knowledge(args.keyword)
|
| 53 |
+
if not results:
|
| 54 |
+
print(f"未找到与 '{args.keyword}' 相关的知识")
|
| 55 |
+
return
|
| 56 |
+
|
| 57 |
+
for _, info in results:
|
| 58 |
+
print(f"\n{'='*50}")
|
| 59 |
+
print(f"{info['name_cn']} | 类别: {info['category']}")
|
| 60 |
+
print(f"{'='*50}")
|
| 61 |
+
print(info["description"])
|
| 62 |
+
print(f"\n📋 投放方法:")
|
| 63 |
+
print(info["disposal"])
|
| 64 |
+
print(f"\n💡 小贴士:")
|
| 65 |
+
for tip in info["tips"]:
|
| 66 |
+
print(f" • {tip}")
|
| 67 |
+
print(f"\n🎯 {info['fun_fact']}")
|
| 68 |
+
print(f"⏱ 降解时间: {info['degradation_time']}")
|
| 69 |
+
|
| 70 |
+
|
| 71 |
+
def cmd_record(args):
|
| 72 |
+
from database import Database
|
| 73 |
+
from predict import GarbageClassifier
|
| 74 |
+
from knowledge import get_class_info
|
| 75 |
+
|
| 76 |
+
db = Database()
|
| 77 |
+
user_id = db.register_user(args.username)
|
| 78 |
+
|
| 79 |
+
classifier = GarbageClassifier(model_path=args.model_path)
|
| 80 |
+
image_path = Path(args.image)
|
| 81 |
+
if not image_path.exists():
|
| 82 |
+
print(f"✗ 图片不存在: {image_path}")
|
| 83 |
+
return
|
| 84 |
+
|
| 85 |
+
results = classifier.predict(str(image_path))
|
| 86 |
+
best = results[0]
|
| 87 |
+
points = db.add_record(user_id, best["class_name"], best["confidence"])
|
| 88 |
+
|
| 89 |
+
print(f"\n✓ 已记录! {best['class_name_cn']} (置信度: {best['confidence']*100:.1f}%)")
|
| 90 |
+
print(f" +{points} 环保积分!")
|
| 91 |
+
|
| 92 |
+
info = get_class_info(best["class_name"])
|
| 93 |
+
if info:
|
| 94 |
+
print(f"\n📋 投放提示: {info['disposal'].split(chr(10))[0]}")
|
| 95 |
+
|
| 96 |
+
|
| 97 |
+
def cmd_stats(args):
|
| 98 |
+
from database import Database
|
| 99 |
+
from knowledge import KNOWLEDGE_BASE
|
| 100 |
+
|
| 101 |
+
db = Database()
|
| 102 |
+
user = db.get_user(args.username)
|
| 103 |
+
if not user:
|
| 104 |
+
print(f"用户 '{args.username}' 不存在,请先使用 record 命令")
|
| 105 |
+
return
|
| 106 |
+
|
| 107 |
+
stats = db.get_user_stats(user["id"])
|
| 108 |
+
print(f"\n{'='*50}")
|
| 109 |
+
print(f" 环保统计 - {stats['username']}")
|
| 110 |
+
print(f"{'='*50}")
|
| 111 |
+
print(f" 总分类次数: {stats['total_classifications']}")
|
| 112 |
+
print(f" 总环保积分: {stats['total_points']}")
|
| 113 |
+
print(f" 今日分类: {stats['today']['count']} 次")
|
| 114 |
+
print(f" 今日积分: {stats['today']['points']}")
|
| 115 |
+
|
| 116 |
+
if stats["class_distribution"]:
|
| 117 |
+
print(f"\n 各类别分类统计:")
|
| 118 |
+
for item in stats["class_distribution"]:
|
| 119 |
+
cn = KNOWLEDGE_BASE.get(item["predicted_class"], {}).get("name_cn", item["predicted_class"])
|
| 120 |
+
print(f" • {cn}: {item['count']} 次")
|
| 121 |
+
|
| 122 |
+
if stats["recent_records"]:
|
| 123 |
+
print(f"\n 最近记录:")
|
| 124 |
+
for r in stats["recent_records"][:5]:
|
| 125 |
+
cn = KNOWLEDGE_BASE.get(r["predicted_class"], {}).get("name_cn", r["predicted_class"])
|
| 126 |
+
print(f" • {cn} | 积分: +{r['points']} | {r['created_at']}")
|
| 127 |
+
|
| 128 |
+
|
| 129 |
+
def cmd_leaderboard(args):
|
| 130 |
+
from database import Database
|
| 131 |
+
|
| 132 |
+
db = Database()
|
| 133 |
+
leaders = db.get_leaderboard(args.limit)
|
| 134 |
+
|
| 135 |
+
if not leaders:
|
| 136 |
+
print("暂无环保数据,快去分类吧!")
|
| 137 |
+
return
|
| 138 |
+
|
| 139 |
+
print(f"\n{'='*50}")
|
| 140 |
+
print(" 🏆 环保积分排行榜")
|
| 141 |
+
print(f"{'='*50}")
|
| 142 |
+
print(f" {'排名':>4} {'用户名':<15} {'积分':<8} {'分类次数':<8}")
|
| 143 |
+
print(f" {'-'*35}")
|
| 144 |
+
badges = ["🥇", "🥈", "🥉"]
|
| 145 |
+
for i, u in enumerate(leaders, 1):
|
| 146 |
+
badge = badges[i - 1] if i <= 3 else " "
|
| 147 |
+
print(f" {badge} {i:<2} {u['username']:<15} {u['total_points']:<8} {u['total_classifications']:<8}")
|
| 148 |
+
|
| 149 |
+
|
| 150 |
+
def cmd_web(args):
|
| 151 |
+
from app.api import start_api
|
| 152 |
+
start_api(host=args.host, port=args.port)
|
| 153 |
+
|
| 154 |
+
|
| 155 |
+
def cmd_webui(args):
|
| 156 |
+
from webui import launch_gradio
|
| 157 |
+
launch_gradio(server_port=args.port)
|
| 158 |
+
|
| 159 |
+
|
| 160 |
+
def main():
|
| 161 |
+
parser = argparse.ArgumentParser(
|
| 162 |
+
description="AI 垃圾分类助手 - 环保小能手",
|
| 163 |
+
formatter_class=argparse.RawDescriptionHelpFormatter,
|
| 164 |
+
epilog="""
|
| 165 |
+
使用示例:
|
| 166 |
+
%(prog)s train --data-dir dataset/trashnet
|
| 167 |
+
%(prog)s predict image.jpg
|
| 168 |
+
%(prog)s query 塑料
|
| 169 |
+
%(prog)s record --username 小明 image.jpg
|
| 170 |
+
%(prog)s stats --username 小明
|
| 171 |
+
%(prog)s leaderboard
|
| 172 |
+
%(prog)s web # 启动 API 服务 (供小程序调用)
|
| 173 |
+
%(prog)s webui # 启动 Gradio 网页界面
|
| 174 |
+
""",
|
| 175 |
+
)
|
| 176 |
+
sub = parser.add_subparsers(dest="command", help="可用命令")
|
| 177 |
+
|
| 178 |
+
p = sub.add_parser("train", help="训练分类模型")
|
| 179 |
+
p.add_argument("--data-dir", default=str(DATASET_DIR))
|
| 180 |
+
p.add_argument("--model-dir", default=str(MODEL_DIR))
|
| 181 |
+
p.add_argument("--epochs", type=int, default=30)
|
| 182 |
+
p.add_argument("--batch-size", type=int, default=32)
|
| 183 |
+
p.add_argument("--lr", type=float, default=0.001)
|
| 184 |
+
|
| 185 |
+
p = sub.add_parser("predict", help="分类垃圾图片")
|
| 186 |
+
p.add_argument("image")
|
| 187 |
+
p.add_argument("--model-path", default=str(MODEL_PATH))
|
| 188 |
+
p.add_argument("--top-k", type=int, default=3)
|
| 189 |
+
p.add_argument("--no-detail", dest="detail", action="store_false", default=True)
|
| 190 |
+
|
| 191 |
+
p = sub.add_parser("query", help="查询垃圾分类知识")
|
| 192 |
+
p.add_argument("keyword")
|
| 193 |
+
|
| 194 |
+
p = sub.add_parser("record", help="分类并记录积分")
|
| 195 |
+
p.add_argument("image")
|
| 196 |
+
p.add_argument("--username", default="default")
|
| 197 |
+
p.add_argument("--model-path", default=str(MODEL_PATH))
|
| 198 |
+
|
| 199 |
+
p = sub.add_parser("stats", help="查看个人统计")
|
| 200 |
+
p.add_argument("--username", default="default")
|
| 201 |
+
|
| 202 |
+
p = sub.add_parser("leaderboard", help="查看排行榜")
|
| 203 |
+
p.add_argument("--limit", type=int, default=10)
|
| 204 |
+
|
| 205 |
+
p = sub.add_parser("web", help="启动 API 服务")
|
| 206 |
+
p.add_argument("--host", default="0.0.0.0")
|
| 207 |
+
p.add_argument("--port", type=int, default=8000)
|
| 208 |
+
|
| 209 |
+
p = sub.add_parser("webui", help="启动 Gradio 网页界面")
|
| 210 |
+
p.add_argument("--port", type=int, default=7860)
|
| 211 |
+
|
| 212 |
+
args = parser.parse_args()
|
| 213 |
+
|
| 214 |
+
cmds = {
|
| 215 |
+
"train": cmd_train,
|
| 216 |
+
"predict": cmd_predict,
|
| 217 |
+
"query": cmd_query,
|
| 218 |
+
"record": cmd_record,
|
| 219 |
+
"stats": cmd_stats,
|
| 220 |
+
"leaderboard": cmd_leaderboard,
|
| 221 |
+
"web": cmd_web,
|
| 222 |
+
"webui": cmd_webui,
|
| 223 |
+
}
|
| 224 |
+
fn = cmds.get(args.command)
|
| 225 |
+
if fn:
|
| 226 |
+
fn(args)
|
| 227 |
+
else:
|
| 228 |
+
parser.print_help()
|
| 229 |
+
|
| 230 |
+
|
| 231 |
+
if __name__ == "__main__":
|
| 232 |
+
main()
|
models/.gitkeep
ADDED
|
File without changes
|
models/evaluation_report.txt
ADDED
|
@@ -0,0 +1,26 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
AI 垃圾分类助手 - 模型评估报告
|
| 2 |
+
=======================================================
|
| 3 |
+
训练设备: mps
|
| 4 |
+
训练轮数: 30
|
| 5 |
+
批次大小: 32
|
| 6 |
+
学习率: 0.001
|
| 7 |
+
|
| 8 |
+
最佳验证准确率: 94.41%
|
| 9 |
+
测试集准确率: 92.99%
|
| 10 |
+
|
| 11 |
+
各类别准确率:
|
| 12 |
+
纸板 (cardboard): 96.77%
|
| 13 |
+
玻璃 (glass): 90.79%
|
| 14 |
+
金属 (metal): 93.65%
|
| 15 |
+
纸张 (paper): 96.67%
|
| 16 |
+
塑料 (plastic): 91.67%
|
| 17 |
+
其他垃圾 (trash): 77.27%
|
| 18 |
+
|
| 19 |
+
混淆矩阵:
|
| 20 |
+
cardb glass metal paper plast trash
|
| 21 |
+
card: 60 1 1 0 0 0
|
| 22 |
+
glas: 0 69 3 0 4 0
|
| 23 |
+
meta: 0 2 59 1 1 0
|
| 24 |
+
pape: 0 0 1 87 0 2
|
| 25 |
+
plas: 0 3 0 2 66 1
|
| 26 |
+
tras: 0 1 2 1 1 17
|
models/garbage_model.pth
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:8ac534413ac47e735c01822d3b11ec8d9e70e71b6b90410ab8c6de9145719df1
|
| 3 |
+
size 18532291
|
models/training_curves.png
ADDED
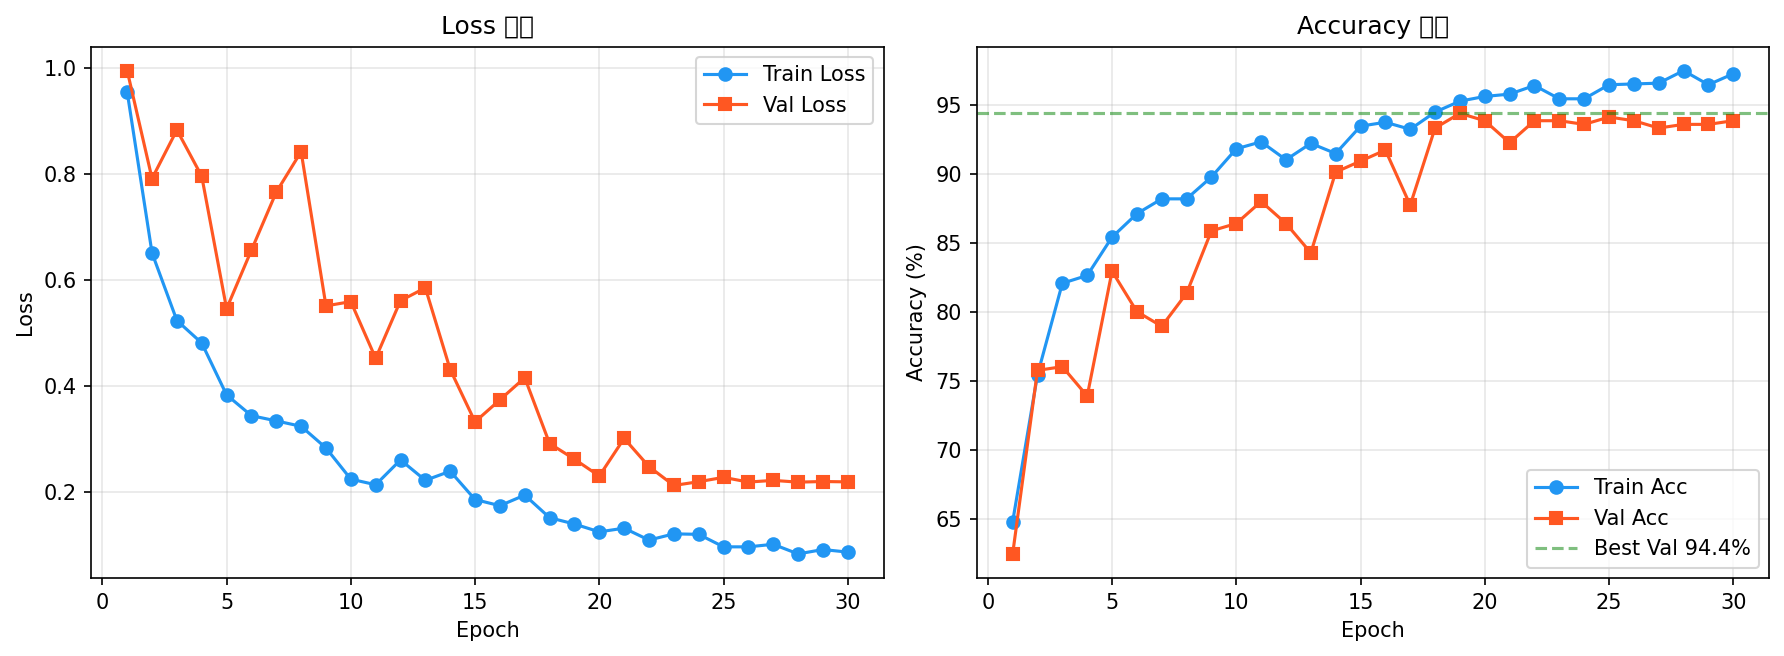
|
predict.py
ADDED
|
@@ -0,0 +1,80 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
AI 垃圾分类助手 - 预测模块
|
| 3 |
+
使用训练好的模型进行垃圾图像分类
|
| 4 |
+
"""
|
| 5 |
+
|
| 6 |
+
import torch
|
| 7 |
+
import torch.nn as nn
|
| 8 |
+
from torchvision import transforms
|
| 9 |
+
from torchvision.models import mobilenet_v3_small
|
| 10 |
+
from PIL import Image
|
| 11 |
+
from pathlib import Path
|
| 12 |
+
from config import CLASS_NAMES, CLASS_NAMES_CN, MODEL_PATH as DEFAULT_MODEL_PATH
|
| 13 |
+
|
| 14 |
+
|
| 15 |
+
class GarbageClassifier:
|
| 16 |
+
def __init__(self, model_path=None, device=None):
|
| 17 |
+
model_path = model_path or str(DEFAULT_MODEL_PATH)
|
| 18 |
+
self.device = device or self._get_device()
|
| 19 |
+
self.class_names = CLASS_NAMES
|
| 20 |
+
self.class_names_cn = CLASS_NAMES_CN
|
| 21 |
+
self.model = self._load_model(model_path)
|
| 22 |
+
self.model.eval()
|
| 23 |
+
|
| 24 |
+
self.transform = transforms.Compose([
|
| 25 |
+
transforms.Resize((256, 256)),
|
| 26 |
+
transforms.CenterCrop(224),
|
| 27 |
+
transforms.ToTensor(),
|
| 28 |
+
transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
|
| 29 |
+
])
|
| 30 |
+
|
| 31 |
+
def _get_device(self):
|
| 32 |
+
if torch.backends.mps.is_available():
|
| 33 |
+
return torch.device("mps")
|
| 34 |
+
elif torch.cuda.is_available():
|
| 35 |
+
return torch.device("cuda")
|
| 36 |
+
return torch.device("cpu")
|
| 37 |
+
|
| 38 |
+
def _load_model(self, model_path):
|
| 39 |
+
model = mobilenet_v3_small(weights=None)
|
| 40 |
+
in_features = model.classifier[3].in_features
|
| 41 |
+
model.classifier[3] = nn.Linear(in_features, len(CLASS_NAMES))
|
| 42 |
+
|
| 43 |
+
path = Path(model_path)
|
| 44 |
+
if not path.exists():
|
| 45 |
+
raise FileNotFoundError(f"模型文件不存在: {model_path}\n请先运行 train.py 训练模型")
|
| 46 |
+
|
| 47 |
+
checkpoint = torch.load(model_path, map_location=self.device, weights_only=True)
|
| 48 |
+
model.load_state_dict(checkpoint["model_state_dict"])
|
| 49 |
+
model = model.to(self.device)
|
| 50 |
+
print(f"✓ 模型加载成功 ({model_path})")
|
| 51 |
+
print(f" 验证准确率: {checkpoint.get('best_acc', 'N/A'):.2f}%")
|
| 52 |
+
return model
|
| 53 |
+
|
| 54 |
+
def predict(self, image_path, top_k=3):
|
| 55 |
+
image = Image.open(image_path).convert("RGB")
|
| 56 |
+
input_tensor = self.transform(image).unsqueeze(0).to(self.device)
|
| 57 |
+
|
| 58 |
+
with torch.no_grad():
|
| 59 |
+
outputs = self.model(input_tensor)
|
| 60 |
+
probabilities = torch.nn.functional.softmax(outputs, dim=1)
|
| 61 |
+
|
| 62 |
+
top_probs, top_indices = torch.topk(probabilities, top_k)
|
| 63 |
+
top_probs = top_probs.squeeze().cpu().numpy()
|
| 64 |
+
top_indices = top_indices.squeeze().cpu().numpy()
|
| 65 |
+
|
| 66 |
+
if top_k == 1:
|
| 67 |
+
top_probs = [top_probs]
|
| 68 |
+
top_indices = [top_indices]
|
| 69 |
+
|
| 70 |
+
return [
|
| 71 |
+
{
|
| 72 |
+
"class_name": self.class_names[idx],
|
| 73 |
+
"class_name_cn": self.class_names_cn[idx],
|
| 74 |
+
"confidence": float(prob),
|
| 75 |
+
}
|
| 76 |
+
for prob, idx in zip(top_probs, top_indices)
|
| 77 |
+
]
|
| 78 |
+
|
| 79 |
+
def predict_batch(self, image_paths):
|
| 80 |
+
return {path: self.predict(path) for path in image_paths}
|
pyproject.toml
ADDED
|
@@ -0,0 +1,25 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
[project]
|
| 2 |
+
name = "ai-garbage-assistant"
|
| 3 |
+
version = "1.0.0"
|
| 4 |
+
description = "AI 垃圾分类助手 - 环保小能手"
|
| 5 |
+
requires-python = ">=3.9"
|
| 6 |
+
dependencies = [
|
| 7 |
+
"torch>=2.0.0",
|
| 8 |
+
"torchvision>=0.15.0",
|
| 9 |
+
"pillow>=10.0.0",
|
| 10 |
+
"numpy>=1.24.0",
|
| 11 |
+
"fastapi>=0.104.0",
|
| 12 |
+
"uvicorn>=0.24.0",
|
| 13 |
+
"python-multipart>=0.0.6",
|
| 14 |
+
"requests>=2.31.0",
|
| 15 |
+
"tqdm>=4.66.0",
|
| 16 |
+
"gradio>=4.0.0",
|
| 17 |
+
"matplotlib>=3.7.0",
|
| 18 |
+
]
|
| 19 |
+
|
| 20 |
+
[project.scripts]
|
| 21 |
+
garbage-assistant = "main:main"
|
| 22 |
+
|
| 23 |
+
[tool.ruff]
|
| 24 |
+
line-length = 100
|
| 25 |
+
target-version = "py39"
|
requirements.txt
ADDED
|
@@ -0,0 +1,11 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
torch>=2.0.0
|
| 2 |
+
torchvision>=0.15.0
|
| 3 |
+
pillow>=10.0.0
|
| 4 |
+
numpy>=1.24.0
|
| 5 |
+
fastapi>=0.104.0
|
| 6 |
+
uvicorn>=0.24.0
|
| 7 |
+
python-multipart>=0.0.6
|
| 8 |
+
gradio>=4.0.0
|
| 9 |
+
requests>=2.31.0
|
| 10 |
+
tqdm>=4.66.0
|
| 11 |
+
pillow-heif>=1.3.0
|
split_dataset.py
ADDED
|
@@ -0,0 +1,83 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
数据集划分脚本
|
| 3 |
+
将 dataset/trashnet/ 按比例拆分为 train / val / test
|
| 4 |
+
生成结构:
|
| 5 |
+
dataset/
|
| 6 |
+
├── trashnet/ (原始数据, 不动)
|
| 7 |
+
├── train/
|
| 8 |
+
│ ├── cardboard/
|
| 9 |
+
│ └── ...
|
| 10 |
+
├── val/
|
| 11 |
+
│ ├── cardboard/
|
| 12 |
+
│ └── ...
|
| 13 |
+
└── test/
|
| 14 |
+
├── cardboard/
|
| 15 |
+
└── ...
|
| 16 |
+
"""
|
| 17 |
+
|
| 18 |
+
import argparse
|
| 19 |
+
import random
|
| 20 |
+
import shutil
|
| 21 |
+
from pathlib import Path
|
| 22 |
+
|
| 23 |
+
|
| 24 |
+
def split_dataset(data_dir, output_dir, train_ratio=0.7, val_ratio=0.15, seed=42):
|
| 25 |
+
data_dir = Path(data_dir)
|
| 26 |
+
output_dir = Path(output_dir)
|
| 27 |
+
|
| 28 |
+
if not data_dir.exists():
|
| 29 |
+
print(f"✗ 数据集路径不存在: {data_dir}")
|
| 30 |
+
return
|
| 31 |
+
|
| 32 |
+
random.seed(seed)
|
| 33 |
+
|
| 34 |
+
# 收集所有类别
|
| 35 |
+
classes = sorted([d.name for d in data_dir.iterdir() if d.is_dir()])
|
| 36 |
+
print(f"发现 {len(classes)} 个类别: {classes}")
|
| 37 |
+
|
| 38 |
+
splits = {"train": train_ratio, "val": val_ratio, "test": 1 - train_ratio - val_ratio}
|
| 39 |
+
print(f"\n划分比例: {splits}")
|
| 40 |
+
|
| 41 |
+
for cls in classes:
|
| 42 |
+
src_dir = data_dir / cls
|
| 43 |
+
images = sorted([f for f in src_dir.iterdir() if f.is_file()])
|
| 44 |
+
random.shuffle(images)
|
| 45 |
+
|
| 46 |
+
n = len(images)
|
| 47 |
+
n_train = int(n * train_ratio)
|
| 48 |
+
n_val = int(n * val_ratio)
|
| 49 |
+
|
| 50 |
+
split_files = {
|
| 51 |
+
"train": images[:n_train],
|
| 52 |
+
"val": images[n_train:n_train + n_val],
|
| 53 |
+
"test": images[n_train + n_val:],
|
| 54 |
+
}
|
| 55 |
+
|
| 56 |
+
for split_name, files in split_files.items():
|
| 57 |
+
dest_dir = output_dir / split_name / cls
|
| 58 |
+
dest_dir.mkdir(parents=True, exist_ok=True)
|
| 59 |
+
for f in files:
|
| 60 |
+
shutil.copy2(f, dest_dir / f.name)
|
| 61 |
+
|
| 62 |
+
print(f" {cls:12s}: train={len(split_files['train']):4d} "
|
| 63 |
+
f"val={len(split_files['val']):4d} "
|
| 64 |
+
f"test={len(split_files['test']):4d}")
|
| 65 |
+
|
| 66 |
+
print(f"\n✓ 划分完成!")
|
| 67 |
+
print(f" 输出目录: {output_dir.resolve()}")
|
| 68 |
+
print(f" 结构: ")
|
| 69 |
+
print(f" {output_dir.name}/")
|
| 70 |
+
for split_name in ["train", "val", "test"]:
|
| 71 |
+
total = sum(len(list((output_dir / split_name / cls).iterdir())) for cls in classes)
|
| 72 |
+
print(f" ├── {split_name}/ ({total} 张)")
|
| 73 |
+
|
| 74 |
+
|
| 75 |
+
if __name__ == "__main__":
|
| 76 |
+
parser = argparse.ArgumentParser(description="划分训练集/验证集/测试集")
|
| 77 |
+
parser.add_argument("--data-dir", default="dataset/trashnet", help="原始数据集路径")
|
| 78 |
+
parser.add_argument("--output-dir", default="dataset", help="输出目录 (将在其中创建 train/val/test)")
|
| 79 |
+
parser.add_argument("--train-ratio", type=float, default=0.7, help="训练集比例")
|
| 80 |
+
parser.add_argument("--val-ratio", type=float, default=0.15, help="验证集比例")
|
| 81 |
+
parser.add_argument("--seed", type=int, default=42, help="随机种子")
|
| 82 |
+
args = parser.parse_args()
|
| 83 |
+
split_dataset(args.data_dir, args.output_dir, args.train_ratio, args.val_ratio, args.seed)
|
train.py
ADDED
|
@@ -0,0 +1,388 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
AI 垃圾分类助手 - 训练模块
|
| 3 |
+
支持两种数据目录结构:
|
| 4 |
+
1. 已划分: dataset/train/ + dataset/val/ [+ dataset/test/]
|
| 5 |
+
2. 未划分: dataset/trashnet/ (自动随机划分)
|
| 6 |
+
训练结束后保存 loss 曲线图并输出详细评估报告
|
| 7 |
+
"""
|
| 8 |
+
|
| 9 |
+
import argparse
|
| 10 |
+
import torch
|
| 11 |
+
import torch.nn as nn
|
| 12 |
+
import torch.optim as optim
|
| 13 |
+
from torch.utils.data import DataLoader, random_split
|
| 14 |
+
from torchvision import datasets, transforms
|
| 15 |
+
from torchvision.models import mobilenet_v3_small, MobileNet_V3_Small_Weights
|
| 16 |
+
from pathlib import Path
|
| 17 |
+
from tqdm import tqdm
|
| 18 |
+
import matplotlib
|
| 19 |
+
matplotlib.use("Agg") # 不依赖 GUI 后端
|
| 20 |
+
import matplotlib.pyplot as plt
|
| 21 |
+
import numpy as np
|
| 22 |
+
from config import CLASS_NAMES, CLASS_NAMES_CN
|
| 23 |
+
|
| 24 |
+
|
| 25 |
+
# ── 设备 ──────────────────────────────────────────────
|
| 26 |
+
|
| 27 |
+
def get_device():
|
| 28 |
+
if torch.backends.mps.is_available():
|
| 29 |
+
device = torch.device("mps")
|
| 30 |
+
print("✓ 使用 MPS (Apple Silicon) 加速训练")
|
| 31 |
+
elif torch.cuda.is_available():
|
| 32 |
+
device = torch.device("cuda")
|
| 33 |
+
print("✓ 使用 CUDA 加速训练")
|
| 34 |
+
else:
|
| 35 |
+
device = torch.device("cpu")
|
| 36 |
+
print("⚠ 使用 CPU 训练 (建议使用 MPS/CUDA)")
|
| 37 |
+
return device
|
| 38 |
+
|
| 39 |
+
|
| 40 |
+
# ── 数据预处理 ────────────────────────────────────────
|
| 41 |
+
|
| 42 |
+
def get_transforms():
|
| 43 |
+
train_tf = transforms.Compose([
|
| 44 |
+
transforms.Resize((256, 256)),
|
| 45 |
+
transforms.RandomResizedCrop(224),
|
| 46 |
+
transforms.RandomHorizontalFlip(),
|
| 47 |
+
transforms.RandomRotation(15),
|
| 48 |
+
transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
|
| 49 |
+
transforms.ToTensor(),
|
| 50 |
+
transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
|
| 51 |
+
])
|
| 52 |
+
eval_tf = transforms.Compose([
|
| 53 |
+
transforms.Resize((256, 256)),
|
| 54 |
+
transforms.CenterCrop(224),
|
| 55 |
+
transforms.ToTensor(),
|
| 56 |
+
transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
|
| 57 |
+
])
|
| 58 |
+
return train_tf, eval_tf
|
| 59 |
+
|
| 60 |
+
|
| 61 |
+
# ── 模型 ──────────────────────────────────────────────
|
| 62 |
+
|
| 63 |
+
def create_model(num_classes=6):
|
| 64 |
+
model = mobilenet_v3_small(weights=MobileNet_V3_Small_Weights.IMAGENET1K_V1)
|
| 65 |
+
in_features = model.classifier[3].in_features
|
| 66 |
+
model.classifier[3] = nn.Linear(in_features, num_classes)
|
| 67 |
+
return model
|
| 68 |
+
|
| 69 |
+
|
| 70 |
+
# ── 训练 / 评估 ───────────────────────────────────────
|
| 71 |
+
|
| 72 |
+
def train_epoch(model, loader, criterion, optimizer, device, desc="Training"):
|
| 73 |
+
model.train()
|
| 74 |
+
running_loss = correct = total = 0
|
| 75 |
+
pbar = tqdm(loader, desc=desc, leave=False)
|
| 76 |
+
for inputs, labels in pbar:
|
| 77 |
+
inputs, labels = inputs.to(device), labels.to(device)
|
| 78 |
+
optimizer.zero_grad()
|
| 79 |
+
outputs = model(inputs)
|
| 80 |
+
loss = criterion(outputs, labels)
|
| 81 |
+
loss.backward()
|
| 82 |
+
optimizer.step()
|
| 83 |
+
running_loss += loss.item() * inputs.size(0)
|
| 84 |
+
_, predicted = outputs.max(1)
|
| 85 |
+
total += labels.size(0)
|
| 86 |
+
correct += predicted.eq(labels).sum().item()
|
| 87 |
+
acc = 100.0 * correct / total if total > 0 else 0
|
| 88 |
+
pbar.set_postfix(loss=f"{running_loss/total:.4f}", acc=f"{acc:.1f}%")
|
| 89 |
+
return running_loss / total, 100.0 * correct / total
|
| 90 |
+
|
| 91 |
+
|
| 92 |
+
@torch.no_grad()
|
| 93 |
+
def evaluate(model, loader, criterion, device, desc="Evaluating"):
|
| 94 |
+
model.eval()
|
| 95 |
+
running_loss = correct = total = 0
|
| 96 |
+
pbar = tqdm(loader, desc=desc, leave=False)
|
| 97 |
+
for inputs, labels in pbar:
|
| 98 |
+
inputs, labels = inputs.to(device), labels.to(device)
|
| 99 |
+
outputs = model(inputs)
|
| 100 |
+
loss = criterion(outputs, labels)
|
| 101 |
+
running_loss += loss.item() * inputs.size(0)
|
| 102 |
+
_, predicted = outputs.max(1)
|
| 103 |
+
total += labels.size(0)
|
| 104 |
+
correct += predicted.eq(labels).sum().item()
|
| 105 |
+
acc = 100.0 * correct / total if total > 0 else 0
|
| 106 |
+
pbar.set_postfix(loss=f"{running_loss/total:.4f}", acc=f"{acc:.1f}%")
|
| 107 |
+
return running_loss / total, 100.0 * correct / total
|
| 108 |
+
|
| 109 |
+
|
| 110 |
+
@torch.no_grad()
|
| 111 |
+
def detailed_evaluate(model, loader, class_names, device):
|
| 112 |
+
"""返回: (loss, acc, per_class_acc, confusion_matrix)"""
|
| 113 |
+
model.eval()
|
| 114 |
+
n = len(class_names)
|
| 115 |
+
correct_per_class = np.zeros(n)
|
| 116 |
+
total_per_class = np.zeros(n)
|
| 117 |
+
conf_matrix = np.zeros((n, n), dtype=int)
|
| 118 |
+
criterion = nn.CrossEntropyLoss()
|
| 119 |
+
total_loss = total_samples = 0
|
| 120 |
+
|
| 121 |
+
for inputs, labels in tqdm(loader, desc="详细评估", leave=False):
|
| 122 |
+
inputs, labels = inputs.to(device), labels.to(device)
|
| 123 |
+
outputs = model(inputs)
|
| 124 |
+
loss = criterion(outputs, labels)
|
| 125 |
+
total_loss += loss.item() * inputs.size(0)
|
| 126 |
+
total_samples += inputs.size(0)
|
| 127 |
+
_, predicted = outputs.max(1)
|
| 128 |
+
|
| 129 |
+
for t, p in zip(labels.cpu().numpy(), predicted.cpu().numpy()):
|
| 130 |
+
conf_matrix[t, p] += 1
|
| 131 |
+
total_per_class[t] += 1
|
| 132 |
+
if t == p:
|
| 133 |
+
correct_per_class[t] += 1
|
| 134 |
+
|
| 135 |
+
avg_loss = total_loss / total_samples
|
| 136 |
+
overall_acc = 100.0 * correct_per_class.sum() / total_per_class.sum()
|
| 137 |
+
per_class_acc = 100.0 * correct_per_class / np.maximum(total_per_class, 1)
|
| 138 |
+
return avg_loss, overall_acc, per_class_acc, conf_matrix
|
| 139 |
+
|
| 140 |
+
|
| 141 |
+
# ── 绘图 ──────────────────────────────────────────────
|
| 142 |
+
|
| 143 |
+
def plot_training_curves(history, save_path):
|
| 144 |
+
"""绘制并保存 Loss / Accuracy 曲线图"""
|
| 145 |
+
epochs = range(1, len(history["train_loss"]) + 1)
|
| 146 |
+
|
| 147 |
+
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4.5))
|
| 148 |
+
|
| 149 |
+
# Loss
|
| 150 |
+
ax1.plot(epochs, history["train_loss"], "o-", label="Train Loss", color="#2196F3")
|
| 151 |
+
ax1.plot(epochs, history["val_loss"], "s-", label="Val Loss", color="#FF5722")
|
| 152 |
+
ax1.set_xlabel("Epoch")
|
| 153 |
+
ax1.set_ylabel("Loss")
|
| 154 |
+
ax1.set_title("Loss 曲线")
|
| 155 |
+
ax1.legend()
|
| 156 |
+
ax1.grid(True, alpha=0.3)
|
| 157 |
+
|
| 158 |
+
# Accuracy
|
| 159 |
+
ax2.plot(epochs, history["train_acc"], "o-", label="Train Acc", color="#2196F3")
|
| 160 |
+
ax2.plot(epochs, history["val_acc"], "s-", label="Val Acc", color="#FF5722")
|
| 161 |
+
ax2.axhline(y=history["best_acc"], color="green", linestyle="--", alpha=0.5,
|
| 162 |
+
label=f"Best Val {history['best_acc']:.1f}%")
|
| 163 |
+
ax2.set_xlabel("Epoch")
|
| 164 |
+
ax2.set_ylabel("Accuracy (%)")
|
| 165 |
+
ax2.set_title("Accuracy 曲线")
|
| 166 |
+
ax2.legend()
|
| 167 |
+
ax2.grid(True, alpha=0.3)
|
| 168 |
+
|
| 169 |
+
plt.tight_layout()
|
| 170 |
+
plt.savefig(save_path, dpi=150, bbox_inches="tight")
|
| 171 |
+
plt.close()
|
| 172 |
+
print(f" 📊 训练曲线已保存: {save_path}")
|
| 173 |
+
|
| 174 |
+
|
| 175 |
+
# ── 评估报告 ──────────────────────────────────────────
|
| 176 |
+
|
| 177 |
+
def print_evaluation_report(class_names, per_class_acc, conf_matrix):
|
| 178 |
+
"""打印详细的评估报告"""
|
| 179 |
+
print(f"\n{'='*55}")
|
| 180 |
+
print(f" 详细评估报告")
|
| 181 |
+
print(f"{'='*55}")
|
| 182 |
+
print(f" 类别准确率:")
|
| 183 |
+
for i, name in enumerate(class_names):
|
| 184 |
+
cn = CLASS_NAMES_CN[i] if i < len(CLASS_NAMES_CN) else name
|
| 185 |
+
bar = "█" * int(per_class_acc[i] // 5) + "░" * (20 - int(per_class_acc[i] // 5))
|
| 186 |
+
print(f" {i}. {cn:8s} ({name:10s}): {per_class_acc[i]:5.1f}% [{bar}]")
|
| 187 |
+
print(f"{'─'*55}")
|
| 188 |
+
|
| 189 |
+
# 混淆矩阵
|
| 190 |
+
print(f" 混淆矩阵 (行=真实, 列=预测):")
|
| 191 |
+
header = "".join(f"{short:>6}" for short in [c[:5] for c in class_names])
|
| 192 |
+
print(f" {'':>6}{header}")
|
| 193 |
+
for i in range(len(class_names)):
|
| 194 |
+
row = "".join(f"{conf_matrix[i, j]:>6}" for j in range(len(class_names)))
|
| 195 |
+
cn = CLASS_NAMES_CN[i][:2] if i < len(CLASS_NAMES_CN) else class_names[i][:2]
|
| 196 |
+
print(f" {cn:>4}: {row} {per_class_acc[i]:.1f}%")
|
| 197 |
+
|
| 198 |
+
# 易混淆对
|
| 199 |
+
print(f"\n 易混淆组合 (非对角线最高):")
|
| 200 |
+
n = len(class_names)
|
| 201 |
+
pairs = []
|
| 202 |
+
for i in range(n):
|
| 203 |
+
for j in range(n):
|
| 204 |
+
if i != j and conf_matrix[i, j] > 0:
|
| 205 |
+
pairs.append((conf_matrix[i, j], i, j))
|
| 206 |
+
pairs.sort(reverse=True)
|
| 207 |
+
for count, i, j in pairs[:3]:
|
| 208 |
+
cn_i = CLASS_NAMES_CN[i] if i < len(CLASS_NAMES_CN) else class_names[i]
|
| 209 |
+
cn_j = CLASS_NAMES_CN[j] if j < len(CLASS_NAMES_CN) else class_names[j]
|
| 210 |
+
ratio = count / max(conf_matrix[i].sum(), 1) * 100
|
| 211 |
+
print(f" {cn_i} → {cn_j}: {count} 次 ({ratio:.1f}%)")
|
| 212 |
+
|
| 213 |
+
|
| 214 |
+
# ── 数据加载 ──────────────────────────────────────────
|
| 215 |
+
|
| 216 |
+
def load_split_data(data_dir, train_tf, eval_tf, batch_size):
|
| 217 |
+
"""加载已划分的数据集 (train/val/test 子目录)"""
|
| 218 |
+
train_dir = data_dir / "train"
|
| 219 |
+
val_dir = data_dir / "val"
|
| 220 |
+
if not train_dir.exists() or not val_dir.exists():
|
| 221 |
+
return None
|
| 222 |
+
|
| 223 |
+
train_dataset = datasets.ImageFolder(root=str(train_dir), transform=train_tf)
|
| 224 |
+
val_dataset = datasets.ImageFolder(root=str(val_dir), transform=eval_tf)
|
| 225 |
+
|
| 226 |
+
train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=0)
|
| 227 |
+
val_loader = DataLoader(val_dataset, batch_size=batch_size, shuffle=False, num_workers=0)
|
| 228 |
+
|
| 229 |
+
test_loader = None
|
| 230 |
+
test_dir = data_dir / "test"
|
| 231 |
+
if test_dir.exists():
|
| 232 |
+
test_dataset = datasets.ImageFolder(root=str(test_dir), transform=eval_tf)
|
| 233 |
+
test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False, num_workers=0)
|
| 234 |
+
|
| 235 |
+
return train_loader, val_loader, test_loader, train_dataset.classes
|
| 236 |
+
|
| 237 |
+
|
| 238 |
+
def load_random_split_data(data_dir, train_tf, eval_tf, batch_size):
|
| 239 |
+
"""从单目录随机划分"""
|
| 240 |
+
full_dataset = datasets.ImageFolder(root=str(data_dir), transform=train_tf)
|
| 241 |
+
train_size = int(0.8 * len(full_dataset))
|
| 242 |
+
val_size = len(full_dataset) - train_size
|
| 243 |
+
train_dataset, val_dataset = random_split(full_dataset, [train_size, val_size])
|
| 244 |
+
val_dataset.dataset.transform = eval_tf
|
| 245 |
+
|
| 246 |
+
train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=0)
|
| 247 |
+
val_loader = DataLoader(val_dataset, batch_size=batch_size, shuffle=False, num_workers=0)
|
| 248 |
+
|
| 249 |
+
return train_loader, val_loader, None, full_dataset.classes
|
| 250 |
+
|
| 251 |
+
|
| 252 |
+
# ── 主训练流程 ────────────────────────────────────────
|
| 253 |
+
|
| 254 |
+
def train(args):
|
| 255 |
+
device = get_device()
|
| 256 |
+
data_dir = Path(args.data_dir)
|
| 257 |
+
model_dir = Path(args.model_dir)
|
| 258 |
+
model_dir.mkdir(parents=True, exist_ok=True)
|
| 259 |
+
|
| 260 |
+
if not data_dir.exists():
|
| 261 |
+
print(f"✗ 数据集路径不存在: {data_dir}")
|
| 262 |
+
print("请将数据集放在以下结构之一:")
|
| 263 |
+
print(f" {data_dir}/ ├── cardboard/ └── ... (自动 80/20 划分)")
|
| 264 |
+
print(f" 或运行 split_dataset.py 划分后使用:")
|
| 265 |
+
print(f" {data_dir}/train/ ├── cardboard/ └── ...")
|
| 266 |
+
print(f" {data_dir}/val/ ├── cardboard/ └── ...")
|
| 267 |
+
return
|
| 268 |
+
|
| 269 |
+
train_tf, eval_tf = get_transforms()
|
| 270 |
+
|
| 271 |
+
if (data_dir / "train").exists():
|
| 272 |
+
result = load_split_data(data_dir, train_tf, eval_tf, args.batch_size)
|
| 273 |
+
if result:
|
| 274 |
+
train_loader, val_loader, test_loader, classes = result
|
| 275 |
+
print(f"\n检测到已划分的数据集")
|
| 276 |
+
else:
|
| 277 |
+
result = load_random_split_data(data_dir, train_tf, eval_tf, args.batch_size)
|
| 278 |
+
if result:
|
| 279 |
+
train_loader, val_loader, test_loader, classes = result
|
| 280 |
+
print(f"\n检测到未划分的数据集 (自动 80/20 随机划分)")
|
| 281 |
+
|
| 282 |
+
print(f" 类别 ({len(classes)}): {classes}")
|
| 283 |
+
print(f" 训练集: {len(train_loader.dataset)} 张")
|
| 284 |
+
print(f" 验证集: {len(val_loader.dataset)} 张")
|
| 285 |
+
if test_loader:
|
| 286 |
+
print(f" 测试集: {len(test_loader.dataset)} 张")
|
| 287 |
+
|
| 288 |
+
model = create_model(num_classes=len(classes)).to(device)
|
| 289 |
+
criterion = nn.CrossEntropyLoss()
|
| 290 |
+
optimizer = optim.Adam(model.parameters(), lr=args.lr)
|
| 291 |
+
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=args.epochs)
|
| 292 |
+
|
| 293 |
+
# ── 训练循环 ──
|
| 294 |
+
history = {"train_loss": [], "train_acc": [], "val_loss": [], "val_acc": [], "best_acc": 0.0}
|
| 295 |
+
best_acc = 0.0
|
| 296 |
+
print(f"\n开始训练 (共 {args.epochs} 轮)...")
|
| 297 |
+
print(f"{'─'*65}")
|
| 298 |
+
|
| 299 |
+
for epoch in range(1, args.epochs + 1):
|
| 300 |
+
train_loss, train_acc = train_epoch(
|
| 301 |
+
model, train_loader, criterion, optimizer, device,
|
| 302 |
+
desc=f"Epoch {epoch}/{args.epochs}",
|
| 303 |
+
)
|
| 304 |
+
val_loss, val_acc = evaluate(model, val_loader, criterion, device, desc="Validating")
|
| 305 |
+
scheduler.step()
|
| 306 |
+
|
| 307 |
+
history["train_loss"].append(train_loss)
|
| 308 |
+
history["train_acc"].append(train_acc)
|
| 309 |
+
history["val_loss"].append(val_loss)
|
| 310 |
+
history["val_acc"].append(val_acc)
|
| 311 |
+
|
| 312 |
+
print(
|
| 313 |
+
f"Epoch {epoch:2d}/{args.epochs} | "
|
| 314 |
+
f"Train Loss: {train_loss:.4f} Acc: {train_acc:.2f}% | "
|
| 315 |
+
f"Val Loss: {val_loss:.4f} Acc: {val_acc:.2f}% | "
|
| 316 |
+
f"LR: {scheduler.get_last_lr()[0]:.2e}"
|
| 317 |
+
)
|
| 318 |
+
|
| 319 |
+
if val_acc > best_acc:
|
| 320 |
+
best_acc = val_acc
|
| 321 |
+
history["best_acc"] = best_acc
|
| 322 |
+
model_path = model_dir / "garbage_model.pth"
|
| 323 |
+
torch.save({
|
| 324 |
+
"epoch": epoch,
|
| 325 |
+
"model_state_dict": model.state_dict(),
|
| 326 |
+
"optimizer_state_dict": optimizer.state_dict(),
|
| 327 |
+
"best_acc": best_acc,
|
| 328 |
+
"class_names": classes,
|
| 329 |
+
}, str(model_path))
|
| 330 |
+
print(f" ✓ 保存最佳模型 (验证准确率: {best_acc:.2f}%)")
|
| 331 |
+
|
| 332 |
+
# ── 训练结束 ──
|
| 333 |
+
print(f"{'─'*65}")
|
| 334 |
+
print(f"训练完成!最佳验证准确率: {best_acc:.2f}%")
|
| 335 |
+
|
| 336 |
+
# 绘制训练曲线
|
| 337 |
+
plot_path = model_dir / "training_curves.png"
|
| 338 |
+
plot_training_curves(history, plot_path)
|
| 339 |
+
|
| 340 |
+
# 测试集详细评估
|
| 341 |
+
if test_loader:
|
| 342 |
+
print(f"\n{'='*55}")
|
| 343 |
+
print(f" 测试集最终评估")
|
| 344 |
+
print(f"{'='*55}")
|
| 345 |
+
|
| 346 |
+
test_loss, test_acc, per_class_acc, conf_matrix = detailed_evaluate(
|
| 347 |
+
model, test_loader, classes, device
|
| 348 |
+
)
|
| 349 |
+
print(f" 测试集 Loss: {test_loss:.4f} | 准确率: {test_acc:.2f}%")
|
| 350 |
+
print_evaluation_report(classes, per_class_acc, conf_matrix)
|
| 351 |
+
|
| 352 |
+
# 追加测试结果到报告文件
|
| 353 |
+
report_path = model_dir / "evaluation_report.txt"
|
| 354 |
+
with open(report_path, "w", encoding="utf-8") as f:
|
| 355 |
+
f.write(f"AI 垃圾分类助手 - 模型评估报告\n")
|
| 356 |
+
f.write(f"{'='*55}\n")
|
| 357 |
+
f.write(f"训练设备: {device}\n")
|
| 358 |
+
f.write(f"训练轮数: {args.epochs}\n")
|
| 359 |
+
f.write(f"批次大小: {args.batch_size}\n")
|
| 360 |
+
f.write(f"学习率: {args.lr}\n\n")
|
| 361 |
+
f.write(f"最佳验证准确率: {best_acc:.2f}%\n")
|
| 362 |
+
f.write(f"测试集准确率: {test_acc:.2f}%\n\n")
|
| 363 |
+
f.write(f"各类别准确率:\n")
|
| 364 |
+
for i, name in enumerate(classes):
|
| 365 |
+
cn = CLASS_NAMES_CN[i] if i < len(CLASS_NAMES_CN) else name
|
| 366 |
+
f.write(f" {cn} ({name}): {per_class_acc[i]:.2f}%\n")
|
| 367 |
+
f.write(f"\n混淆矩阵:\n")
|
| 368 |
+
f.write(f"{'':>6}" + "".join(f"{c[:5]:>6}" for c in classes) + "\n")
|
| 369 |
+
for i in range(len(classes)):
|
| 370 |
+
f.write(f"{classes[i][:4]:>4}: " + "".join(f"{conf_matrix[i,j]:>6}" for j in range(len(classes))) + "\n")
|
| 371 |
+
print(f" 📄 评估报告已保存: {report_path}")
|
| 372 |
+
|
| 373 |
+
print(f"\n✓ 模型: {model_dir / 'garbage_model.pth'}")
|
| 374 |
+
print(f"✓ 曲线图: {plot_path}")
|
| 375 |
+
print(f" 如需启动 Web 界面: python main.py webui")
|
| 376 |
+
|
| 377 |
+
|
| 378 |
+
# ── CLI ───────────────────────────────────────────────
|
| 379 |
+
|
| 380 |
+
if __name__ == "__main__":
|
| 381 |
+
parser = argparse.ArgumentParser(description="训练垃圾分类模型")
|
| 382 |
+
parser.add_argument("--data-dir", default="dataset")
|
| 383 |
+
parser.add_argument("--model-dir", default="models")
|
| 384 |
+
parser.add_argument("--epochs", type=int, default=30)
|
| 385 |
+
parser.add_argument("--batch-size", type=int, default=32)
|
| 386 |
+
parser.add_argument("--lr", type=float, default=0.001)
|
| 387 |
+
args = parser.parse_args()
|
| 388 |
+
train(args)
|
uv.lock
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|
webui.py
ADDED
|
@@ -0,0 +1,790 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
"""
|
| 2 |
+
AI 垃圾分类助手 - 高级 Gradio UI 版本
|
| 3 |
+
特点:
|
| 4 |
+
1. 缩略图显示
|
| 5 |
+
2. 点击查看原图
|
| 6 |
+
3. Tabs 分区布局
|
| 7 |
+
4. 排行榜折叠
|
| 8 |
+
5. 更现代化卡片式 UI
|
| 9 |
+
6. 更清晰的视觉层级
|
| 10 |
+
"""
|
| 11 |
+
|
| 12 |
+
import base64
|
| 13 |
+
from PIL import Image
|
| 14 |
+
|
| 15 |
+
# HEIC 支持
|
| 16 |
+
try:
|
| 17 |
+
import pillow_heif
|
| 18 |
+
pillow_heif.register_heif_opener()
|
| 19 |
+
HEIF_SUPPORT = True
|
| 20 |
+
except Exception:
|
| 21 |
+
HEIF_SUPPORT = False
|
| 22 |
+
import random
|
| 23 |
+
import gradio as gr
|
| 24 |
+
from knowledge import get_class_info
|
| 25 |
+
from database import Database
|
| 26 |
+
|
| 27 |
+
# 数据库
|
| 28 |
+
# --------------------------------------------------
|
| 29 |
+
db = Database()
|
| 30 |
+
|
| 31 |
+
# 分类器懒加载
|
| 32 |
+
_classifier = None
|
| 33 |
+
TEMP_IMG = "temp_upload.jpg"
|
| 34 |
+
|
| 35 |
+
|
| 36 |
+
# --------------------------------------------------
|
| 37 |
+
# 模型加载
|
| 38 |
+
# --------------------------------------------------
|
| 39 |
+
def get_classifier():
|
| 40 |
+
global _classifier
|
| 41 |
+
|
| 42 |
+
if _classifier is None:
|
| 43 |
+
from predict import GarbageClassifier
|
| 44 |
+
_classifier = GarbageClassifier()
|
| 45 |
+
|
| 46 |
+
return _classifier
|
| 47 |
+
|
| 48 |
+
|
| 49 |
+
# --------------------------------------------------
|
| 50 |
+
# 图片转 base64
|
| 51 |
+
# --------------------------------------------------
|
| 52 |
+
def make_img_data_uri(path):
|
| 53 |
+
with open(path, "rb") as f:
|
| 54 |
+
return (
|
| 55 |
+
"data:image/jpeg;base64,"
|
| 56 |
+
+ base64.b64encode(f.read()).decode()
|
| 57 |
+
)
|
| 58 |
+
|
| 59 |
+
|
| 60 |
+
# --------------------------------------------------
|
| 61 |
+
# 主识别逻辑
|
| 62 |
+
# --------------------------------------------------
|
| 63 |
+
def classify_and_advise(image, username="default"):
|
| 64 |
+
|
| 65 |
+
if image is None:
|
| 66 |
+
return (
|
| 67 |
+
"""
|
| 68 |
+
<div class='empty-card'>
|
| 69 |
+
<h2>⚠️ 未检测到图片</h2>
|
| 70 |
+
<p>请先上传一张垃圾图片</p>
|
| 71 |
+
</div>
|
| 72 |
+
""",
|
| 73 |
+
"",
|
| 74 |
+
""
|
| 75 |
+
)
|
| 76 |
+
|
| 77 |
+
# 加载模型
|
| 78 |
+
try:
|
| 79 |
+
classifier = get_classifier()
|
| 80 |
+
|
| 81 |
+
except FileNotFoundError as e:
|
| 82 |
+
return (
|
| 83 |
+
f"""
|
| 84 |
+
<div class='error-card'>
|
| 85 |
+
<h2>❌ 模型未训练</h2>
|
| 86 |
+
<p>{e}</p>
|
| 87 |
+
<p>请先运行:</p>
|
| 88 |
+
<code>python main.py train</code>
|
| 89 |
+
</div>
|
| 90 |
+
""",
|
| 91 |
+
"",
|
| 92 |
+
""
|
| 93 |
+
)
|
| 94 |
+
|
| 95 |
+
# 推理
|
| 96 |
+
try:
|
| 97 |
+
# 自动兼容 HEIC / HEIF
|
| 98 |
+
if isinstance(image, str):
|
| 99 |
+
|
| 100 |
+
if image.lower().endswith((".heic", ".heif")):
|
| 101 |
+
|
| 102 |
+
if not HEIF_SUPPORT:
|
| 103 |
+
raise RuntimeError(
|
| 104 |
+
"未安装 pillow-heif,请执行: pip install pillow-heif"
|
| 105 |
+
)
|
| 106 |
+
|
| 107 |
+
heif_file = pillow_heif.read_heif(image)
|
| 108 |
+
|
| 109 |
+
image = Image.frombytes(
|
| 110 |
+
heif_file.mode,
|
| 111 |
+
heif_file.size,
|
| 112 |
+
heif_file.data,
|
| 113 |
+
"raw"
|
| 114 |
+
)
|
| 115 |
+
|
| 116 |
+
else:
|
| 117 |
+
image = Image.open(image)
|
| 118 |
+
|
| 119 |
+
img = image.convert("RGB")
|
| 120 |
+
img.save(TEMP_IMG, "JPEG")
|
| 121 |
+
|
| 122 |
+
results = classifier.predict(TEMP_IMG)
|
| 123 |
+
|
| 124 |
+
best = results[0]
|
| 125 |
+
|
| 126 |
+
info = get_class_info(best["class_name"])
|
| 127 |
+
|
| 128 |
+
except Exception as e:
|
| 129 |
+
return (
|
| 130 |
+
f"""
|
| 131 |
+
<div class='error-card'>
|
| 132 |
+
<h2>❌ 识别失败</h2>
|
| 133 |
+
<p>{e}</p>
|
| 134 |
+
</div>
|
| 135 |
+
""",
|
| 136 |
+
"",
|
| 137 |
+
""
|
| 138 |
+
)
|
| 139 |
+
|
| 140 |
+
# --------------------------------------------------
|
| 141 |
+
# 用户记录
|
| 142 |
+
# --------------------------------------------------
|
| 143 |
+
user_id = db.register_user(username)
|
| 144 |
+
|
| 145 |
+
points = db.add_record(
|
| 146 |
+
user_id,
|
| 147 |
+
best["class_name"],
|
| 148 |
+
best["confidence"]
|
| 149 |
+
)
|
| 150 |
+
|
| 151 |
+
stats = db.get_user_stats(user_id)
|
| 152 |
+
|
| 153 |
+
leaderboard = db.get_leaderboard(5)
|
| 154 |
+
|
| 155 |
+
# --------------------------------------------------
|
| 156 |
+
# 图片 data uri
|
| 157 |
+
# --------------------------------------------------
|
| 158 |
+
data_uri = make_img_data_uri(TEMP_IMG)
|
| 159 |
+
|
| 160 |
+
modal_id = f"modal-{random.randint(10000,99999)}"
|
| 161 |
+
|
| 162 |
+
# --------------------------------------------------
|
| 163 |
+
# 结果卡片
|
| 164 |
+
# --------------------------------------------------
|
| 165 |
+
pct = best["confidence"] * 100
|
| 166 |
+
|
| 167 |
+
progress_width = min(max(pct, 5), 100)
|
| 168 |
+
|
| 169 |
+
if pct >= 80:
|
| 170 |
+
result_color = "#2e7d32"
|
| 171 |
+
result_bg = "#e8f5e9"
|
| 172 |
+
|
| 173 |
+
elif pct >= 60:
|
| 174 |
+
result_color = "#ef6c00"
|
| 175 |
+
result_bg = "#fff3e0"
|
| 176 |
+
|
| 177 |
+
else:
|
| 178 |
+
result_color = "#c62828"
|
| 179 |
+
result_bg = "#ffebee"
|
| 180 |
+
|
| 181 |
+
result_html = f"""
|
| 182 |
+
|
| 183 |
+
<div class='result-card'>
|
| 184 |
+
|
| 185 |
+
<div class='thumb-wrapper'>
|
| 186 |
+
|
| 187 |
+
<img
|
| 188 |
+
src='{data_uri}'
|
| 189 |
+
class='thumb-image'
|
| 190 |
+
onclick="document.getElementById('{modal_id}').style.display='flex'"
|
| 191 |
+
>
|
| 192 |
+
|
| 193 |
+
<div class='thumb-text'>🔍 点击查看原图</div>
|
| 194 |
+
|
| 195 |
+
</div>
|
| 196 |
+
|
| 197 |
+
<div class='result-content'>
|
| 198 |
+
|
| 199 |
+
<div class='result-label'>AI 识别结果</div>
|
| 200 |
+
|
| 201 |
+
<div class='result-name' style='color:{result_color};'>
|
| 202 |
+
{best['class_name_cn']}
|
| 203 |
+
</div>
|
| 204 |
+
|
| 205 |
+
<div class='result-category'>
|
| 206 |
+
♻️ {info['category'] if info else '未知分类'}
|
| 207 |
+
</div>
|
| 208 |
+
|
| 209 |
+
<div class='confidence-text'>
|
| 210 |
+
识别置信度:{pct:.1f}%
|
| 211 |
+
</div>
|
| 212 |
+
|
| 213 |
+
<div class='progress-bar-bg'>
|
| 214 |
+
<div
|
| 215 |
+
class='progress-bar-fill'
|
| 216 |
+
style='width:{progress_width}%;background:{result_color};'>
|
| 217 |
+
</div>
|
| 218 |
+
</div>
|
| 219 |
+
|
| 220 |
+
<div class='score-badge'>
|
| 221 |
+
🎉 获得 +{points} 环保积分
|
| 222 |
+
</div>
|
| 223 |
+
|
| 224 |
+
</div>
|
| 225 |
+
|
| 226 |
+
</div>
|
| 227 |
+
|
| 228 |
+
<!-- 原图弹窗 -->
|
| 229 |
+
<div
|
| 230 |
+
id='{modal_id}'
|
| 231 |
+
class='image-modal'
|
| 232 |
+
onclick="this.style.display='none'">
|
| 233 |
+
|
| 234 |
+
<img src='{data_uri}' class='modal-image'>
|
| 235 |
+
|
| 236 |
+
<div class='modal-close'>✕</div>
|
| 237 |
+
|
| 238 |
+
</div>
|
| 239 |
+
|
| 240 |
+
"""
|
| 241 |
+
|
| 242 |
+
# --------------------------------------------------
|
| 243 |
+
# 投放指南
|
| 244 |
+
# --------------------------------------------------
|
| 245 |
+
disposal_html = (
|
| 246 |
+
info["disposal"].replace("\n", "<br>")
|
| 247 |
+
if info else "暂无信息"
|
| 248 |
+
)
|
| 249 |
+
|
| 250 |
+
tips_html = "".join(
|
| 251 |
+
[f"<li>💡 {t}</li>" for t in info["tips"]]
|
| 252 |
+
) if info else ""
|
| 253 |
+
|
| 254 |
+
knowledge_html = f"""
|
| 255 |
+
|
| 256 |
+
<div class='knowledge-card'>
|
| 257 |
+
|
| 258 |
+
<div class='knowledge-title'>
|
| 259 |
+
📋 {info['name_cn']} 投放指南
|
| 260 |
+
</div>
|
| 261 |
+
|
| 262 |
+
<div class='knowledge-body'>
|
| 263 |
+
{disposal_html}
|
| 264 |
+
</div>
|
| 265 |
+
|
| 266 |
+
<div class='tips-title'>💡 分类小贴士</div>
|
| 267 |
+
|
| 268 |
+
<ul class='tips-list'>
|
| 269 |
+
{tips_html}
|
| 270 |
+
</ul>
|
| 271 |
+
|
| 272 |
+
<div class='fun-fact'>
|
| 273 |
+
🎯 {info['fun_fact']}
|
| 274 |
+
</div>
|
| 275 |
+
|
| 276 |
+
<div class='degradation'>
|
| 277 |
+
⏱ 降解时间:{info['degradation_time']}
|
| 278 |
+
</div>
|
| 279 |
+
|
| 280 |
+
</div>
|
| 281 |
+
|
| 282 |
+
"""
|
| 283 |
+
|
| 284 |
+
# --------------------------------------------------
|
| 285 |
+
# 排行榜
|
| 286 |
+
# --------------------------------------------------
|
| 287 |
+
leaderboard_html = ""
|
| 288 |
+
|
| 289 |
+
for i, user in enumerate(leaderboard):
|
| 290 |
+
|
| 291 |
+
medal = ""
|
| 292 |
+
|
| 293 |
+
if i == 0:
|
| 294 |
+
medal = "🥇"
|
| 295 |
+
elif i == 1:
|
| 296 |
+
medal = "🥈"
|
| 297 |
+
elif i == 2:
|
| 298 |
+
medal = "🥉"
|
| 299 |
+
else:
|
| 300 |
+
medal = f"{i+1}."
|
| 301 |
+
|
| 302 |
+
leaderboard_html += f"""
|
| 303 |
+
<div class='leader-item'>
|
| 304 |
+
<span>{medal} {user['username']}</span>
|
| 305 |
+
<span>{user['total_points']} 分</span>
|
| 306 |
+
</div>
|
| 307 |
+
"""
|
| 308 |
+
|
| 309 |
+
stats_html = f"""
|
| 310 |
+
|
| 311 |
+
<div class='stats-card'>
|
| 312 |
+
|
| 313 |
+
<div class='stats-title'>
|
| 314 |
+
📊 {stats['username']} 的环保数据
|
| 315 |
+
</div>
|
| 316 |
+
|
| 317 |
+
<div class='stats-grid'>
|
| 318 |
+
|
| 319 |
+
<div class='stat-box'>
|
| 320 |
+
<div class='stat-number'>{stats['total_points']}</div>
|
| 321 |
+
<div class='stat-label'>总积分</div>
|
| 322 |
+
</div>
|
| 323 |
+
|
| 324 |
+
<div class='stat-box'>
|
| 325 |
+
<div class='stat-number'>{stats['total_classifications']}</div>
|
| 326 |
+
<div class='stat-label'>分类次数</div>
|
| 327 |
+
</div>
|
| 328 |
+
|
| 329 |
+
<div class='stat-box'>
|
| 330 |
+
<div class='stat-number'>{stats['today']['points']}</div>
|
| 331 |
+
<div class='stat-label'>今日积分</div>
|
| 332 |
+
</div>
|
| 333 |
+
|
| 334 |
+
</div>
|
| 335 |
+
|
| 336 |
+
<div class='leaderboard-title'>🏆 环保排行榜 TOP5</div>
|
| 337 |
+
|
| 338 |
+
<div class='leaderboard-list'>
|
| 339 |
+
{leaderboard_html}
|
| 340 |
+
</div>
|
| 341 |
+
|
| 342 |
+
</div>
|
| 343 |
+
|
| 344 |
+
"""
|
| 345 |
+
|
| 346 |
+
return result_html, knowledge_html, stats_html
|
| 347 |
+
|
| 348 |
+
|
| 349 |
+
# --------------------------------------------------
|
| 350 |
+
# CSS
|
| 351 |
+
# --------------------------------------------------
|
| 352 |
+
CSS = """
|
| 353 |
+
|
| 354 |
+
.gradio-container {
|
| 355 |
+
width: 100% !important;
|
| 356 |
+
max-width: 900px !important;
|
| 357 |
+
margin: auto !important;
|
| 358 |
+
overflow-x: hidden !important;
|
| 359 |
+
margin: auto;
|
| 360 |
+
}
|
| 361 |
+
|
| 362 |
+
footer {
|
| 363 |
+
display: none !important;
|
| 364 |
+
}
|
| 365 |
+
|
| 366 |
+
/* 标题 */
|
| 367 |
+
.main-title {
|
| 368 |
+
text-align:center;
|
| 369 |
+
padding: 10px 0 20px 0;
|
| 370 |
+
}
|
| 371 |
+
|
| 372 |
+
/* 提示标签 */
|
| 373 |
+
.class-badge {
|
| 374 |
+
display:inline-block;
|
| 375 |
+
padding:6px 14px;
|
| 376 |
+
border-radius:20px;
|
| 377 |
+
margin:4px;
|
| 378 |
+
font-size:13px;
|
| 379 |
+
font-weight:bold;
|
| 380 |
+
background:#f1f8e9;
|
| 381 |
+
border:1px solid #c5e1a5;
|
| 382 |
+
}
|
| 383 |
+
|
| 384 |
+
/* 上传区域 */
|
| 385 |
+
.upload-panel {
|
| 386 |
+
width: 100%;
|
| 387 |
+
max-width: 900px;
|
| 388 |
+
margin: auto;
|
| 389 |
+
background:white;
|
| 390 |
+
border-radius:18px;
|
| 391 |
+
padding:20px;
|
| 392 |
+
box-shadow:0 4px 15px rgba(0,0,0,0.06);
|
| 393 |
+
}
|
| 394 |
+
|
| 395 |
+
/* 结果卡片 */
|
| 396 |
+
.result-card {
|
| 397 |
+
box-sizing: border-box;
|
| 398 |
+
width: 100%;
|
| 399 |
+
max-width: 900px;
|
| 400 |
+
margin: 10px auto 0 auto;
|
| 401 |
+
display:flex;
|
| 402 |
+
align-items:center;
|
| 403 |
+
gap:20px;
|
| 404 |
+
background:white;
|
| 405 |
+
border-radius:20px;
|
| 406 |
+
padding:20px;
|
| 407 |
+
box-shadow:0 6px 18px rgba(0,0,0,0.08);
|
| 408 |
+
margin-top:5px;
|
| 409 |
+
}
|
| 410 |
+
|
| 411 |
+
.thumb-wrapper {
|
| 412 |
+
text-align:center;
|
| 413 |
+
flex-shrink:0;
|
| 414 |
+
}
|
| 415 |
+
|
| 416 |
+
.thumb-image {
|
| 417 |
+
max-width: 95px;
|
| 418 |
+
min-width: 95px;
|
| 419 |
+
width:95px;
|
| 420 |
+
height:95px;
|
| 421 |
+
object-fit:cover;
|
| 422 |
+
border-radius:14px;
|
| 423 |
+
cursor:pointer;
|
| 424 |
+
border:3px solid #c8e6c9;
|
| 425 |
+
transition:0.2s;
|
| 426 |
+
}
|
| 427 |
+
|
| 428 |
+
.thumb-image:hover {
|
| 429 |
+
transform:scale(1.05);
|
| 430 |
+
}
|
| 431 |
+
|
| 432 |
+
.thumb-text {
|
| 433 |
+
margin-top:6px;
|
| 434 |
+
font-size:11px;
|
| 435 |
+
color:#777;
|
| 436 |
+
}
|
| 437 |
+
|
| 438 |
+
.result-content {
|
| 439 |
+
flex:1;
|
| 440 |
+
}
|
| 441 |
+
|
| 442 |
+
.result-label {
|
| 443 |
+
color:#777;
|
| 444 |
+
font-size:13px;
|
| 445 |
+
}
|
| 446 |
+
|
| 447 |
+
.result-name {
|
| 448 |
+
font-size:34px;
|
| 449 |
+
font-weight:800;
|
| 450 |
+
margin:4px 0;
|
| 451 |
+
}
|
| 452 |
+
|
| 453 |
+
.result-category {
|
| 454 |
+
font-size:15px;
|
| 455 |
+
color:#555;
|
| 456 |
+
margin-bottom:10px;
|
| 457 |
+
}
|
| 458 |
+
|
| 459 |
+
.confidence-text {
|
| 460 |
+
font-size:13px;
|
| 461 |
+
margin-bottom:6px;
|
| 462 |
+
color:#666;
|
| 463 |
+
}
|
| 464 |
+
|
| 465 |
+
.progress-bar-bg {
|
| 466 |
+
width:100%;
|
| 467 |
+
height:10px;
|
| 468 |
+
background:#eeeeee;
|
| 469 |
+
border-radius:999px;
|
| 470 |
+
overflow:hidden;
|
| 471 |
+
}
|
| 472 |
+
|
| 473 |
+
.progress-bar-fill {
|
| 474 |
+
height:100%;
|
| 475 |
+
border-radius:999px;
|
| 476 |
+
}
|
| 477 |
+
|
| 478 |
+
.score-badge {
|
| 479 |
+
display:inline-block;
|
| 480 |
+
margin-top:12px;
|
| 481 |
+
padding:8px 14px;
|
| 482 |
+
background:#fff3e0;
|
| 483 |
+
border-radius:999px;
|
| 484 |
+
color:#ef6c00;
|
| 485 |
+
font-size:13px;
|
| 486 |
+
font-weight:bold;
|
| 487 |
+
}
|
| 488 |
+
|
| 489 |
+
/* 投放指南 */
|
| 490 |
+
.knowledge-card {
|
| 491 |
+
background:white;
|
| 492 |
+
padding:22px;
|
| 493 |
+
border-radius:18px;
|
| 494 |
+
box-shadow:0 4px 15px rgba(0,0,0,0.06);
|
| 495 |
+
}
|
| 496 |
+
|
| 497 |
+
.knowledge-title {
|
| 498 |
+
font-size:22px;
|
| 499 |
+
font-weight:bold;
|
| 500 |
+
color:#2e7d32;
|
| 501 |
+
margin-bottom:15px;
|
| 502 |
+
}
|
| 503 |
+
|
| 504 |
+
.knowledge-body {
|
| 505 |
+
background:#f8f9fa;
|
| 506 |
+
padding:16px;
|
| 507 |
+
border-radius:12px;
|
| 508 |
+
line-height:1.8;
|
| 509 |
+
font-size:15px;
|
| 510 |
+
}
|
| 511 |
+
|
| 512 |
+
.tips-title {
|
| 513 |
+
margin-top:18px;
|
| 514 |
+
font-size:17px;
|
| 515 |
+
font-weight:bold;
|
| 516 |
+
color:#ef6c00;
|
| 517 |
+
}
|
| 518 |
+
|
| 519 |
+
.tips-list {
|
| 520 |
+
margin-top:8px;
|
| 521 |
+
line-height:1.9;
|
| 522 |
+
}
|
| 523 |
+
|
| 524 |
+
.fun-fact {
|
| 525 |
+
margin-top:15px;
|
| 526 |
+
background:#fff8e1;
|
| 527 |
+
padding:12px;
|
| 528 |
+
border-radius:12px;
|
| 529 |
+
color:#e65100;
|
| 530 |
+
font-weight:bold;
|
| 531 |
+
}
|
| 532 |
+
|
| 533 |
+
.degradation {
|
| 534 |
+
margin-top:10px;
|
| 535 |
+
color:#777;
|
| 536 |
+
font-size:13px;
|
| 537 |
+
}
|
| 538 |
+
|
| 539 |
+
/* 环保统计 */
|
| 540 |
+
.stats-card {
|
| 541 |
+
background:white;
|
| 542 |
+
padding:22px;
|
| 543 |
+
border-radius:18px;
|
| 544 |
+
box-shadow:0 4px 15px rgba(0,0,0,0.06);
|
| 545 |
+
}
|
| 546 |
+
|
| 547 |
+
.stats-title {
|
| 548 |
+
font-size:22px;
|
| 549 |
+
font-weight:bold;
|
| 550 |
+
color:#1565c0;
|
| 551 |
+
margin-bottom:20px;
|
| 552 |
+
}
|
| 553 |
+
|
| 554 |
+
.stats-grid {
|
| 555 |
+
display:grid;
|
| 556 |
+
grid-template-columns:repeat(3,1fr);
|
| 557 |
+
gap:15px;
|
| 558 |
+
}
|
| 559 |
+
|
| 560 |
+
.stat-box {
|
| 561 |
+
background:#f5f7fa;
|
| 562 |
+
padding:18px;
|
| 563 |
+
border-radius:14px;
|
| 564 |
+
text-align:center;
|
| 565 |
+
}
|
| 566 |
+
|
| 567 |
+
.stat-number {
|
| 568 |
+
font-size:28px;
|
| 569 |
+
font-weight:bold;
|
| 570 |
+
color:#1565c0;
|
| 571 |
+
}
|
| 572 |
+
|
| 573 |
+
.stat-label {
|
| 574 |
+
margin-top:6px;
|
| 575 |
+
color:#666;
|
| 576 |
+
font-size:13px;
|
| 577 |
+
}
|
| 578 |
+
|
| 579 |
+
.leaderboard-title {
|
| 580 |
+
margin-top:24px;
|
| 581 |
+
font-size:18px;
|
| 582 |
+
font-weight:bold;
|
| 583 |
+
color:#2e7d32;
|
| 584 |
+
}
|
| 585 |
+
|
| 586 |
+
.leaderboard-list {
|
| 587 |
+
margin-top:12px;
|
| 588 |
+
}
|
| 589 |
+
|
| 590 |
+
.leader-item {
|
| 591 |
+
display:flex;
|
| 592 |
+
justify-content:space-between;
|
| 593 |
+
padding:12px 14px;
|
| 594 |
+
background:#f8f9fa;
|
| 595 |
+
border-radius:12px;
|
| 596 |
+
margin-bottom:10px;
|
| 597 |
+
font-size:14px;
|
| 598 |
+
}
|
| 599 |
+
|
| 600 |
+
/* 弹窗 */
|
| 601 |
+
.image-modal {
|
| 602 |
+
display:none;
|
| 603 |
+
position:fixed;
|
| 604 |
+
top:0;
|
| 605 |
+
left:0;
|
| 606 |
+
width:100%;
|
| 607 |
+
height:100%;
|
| 608 |
+
background:rgba(0,0,0,0.92);
|
| 609 |
+
z-index:99999;
|
| 610 |
+
justify-content:center;
|
| 611 |
+
align-items:center;
|
| 612 |
+
cursor:pointer;
|
| 613 |
+
}
|
| 614 |
+
|
| 615 |
+
.modal-image {
|
| 616 |
+
width: auto;
|
| 617 |
+
height: auto;
|
| 618 |
+
object-fit: contain;
|
| 619 |
+
max-width:90%;
|
| 620 |
+
max-height:90%;
|
| 621 |
+
border-radius:10px;
|
| 622 |
+
object-fit:contain;
|
| 623 |
+
}
|
| 624 |
+
|
| 625 |
+
.modal-close {
|
| 626 |
+
position:absolute;
|
| 627 |
+
top:20px;
|
| 628 |
+
right:30px;
|
| 629 |
+
color:white;
|
| 630 |
+
font-size:36px;
|
| 631 |
+
font-weight:bold;
|
| 632 |
+
}
|
| 633 |
+
|
| 634 |
+
/* 空卡片 */
|
| 635 |
+
.empty-card,
|
| 636 |
+
.error-card {
|
| 637 |
+
text-align:center;
|
| 638 |
+
padding:40px;
|
| 639 |
+
background:white;
|
| 640 |
+
border-radius:18px;
|
| 641 |
+
}
|
| 642 |
+
|
| 643 |
+
/* 手机端适配 */
|
| 644 |
+
@media (max-width:768px) {
|
| 645 |
+
|
| 646 |
+
.result-card {
|
| 647 |
+
flex-direction:column;
|
| 648 |
+
text-align:center;
|
| 649 |
+
}
|
| 650 |
+
|
| 651 |
+
.stats-grid {
|
| 652 |
+
grid-template-columns:1fr;
|
| 653 |
+
}
|
| 654 |
+
|
| 655 |
+
.result-name {
|
| 656 |
+
font-size:28px;
|
| 657 |
+
}
|
| 658 |
+
}
|
| 659 |
+
|
| 660 |
+
"""
|
| 661 |
+
|
| 662 |
+
|
| 663 |
+
# --------------------------------------------------
|
| 664 |
+
# 分类提示
|
| 665 |
+
# --------------------------------------------------
|
| 666 |
+
CLASS_HINT = """
|
| 667 |
+
<div style='text-align:center;margin-bottom:12px;'>
|
| 668 |
+
|
| 669 |
+
<span class='class-badge'>🥤 塑料</span>
|
| 670 |
+
<span class='class-badge'>📦 纸板</span>
|
| 671 |
+
<span class='class-badge'>📄 纸张</span>
|
| 672 |
+
<span class='class-badge'>🍾 玻璃</span>
|
| 673 |
+
<span class='class-badge'>🥫 金属</span>
|
| 674 |
+
<span class='class-badge'>🍂 其他垃圾</span>
|
| 675 |
+
|
| 676 |
+
<div style='margin-top:10px;color:#777;font-size:13px;'>
|
| 677 |
+
本系统当前支持以上 6 类垃圾识别
|
| 678 |
+
</div>
|
| 679 |
+
|
| 680 |
+
</div>
|
| 681 |
+
"""
|
| 682 |
+
|
| 683 |
+
|
| 684 |
+
# --------------------------------------------------
|
| 685 |
+
# Gradio UI
|
| 686 |
+
# --------------------------------------------------
|
| 687 |
+
with gr.Blocks(fill_width=False,
|
| 688 |
+
title="AI 垃圾分类助手",
|
| 689 |
+
theme=gr.themes.Soft(primary_hue="green"),
|
| 690 |
+
css=CSS
|
| 691 |
+
) as demo:
|
| 692 |
+
|
| 693 |
+
gr.Markdown(
|
| 694 |
+
"""
|
| 695 |
+
<div class='main-title'>
|
| 696 |
+
<h1>♻️ AI 垃圾分类助手</h1>
|
| 697 |
+
<h3>拍照识别 · 投放指南 · 环保积分</h3>
|
| 698 |
+
</div>
|
| 699 |
+
"""
|
| 700 |
+
)
|
| 701 |
+
|
| 702 |
+
gr.HTML(CLASS_HINT)
|
| 703 |
+
|
| 704 |
+
# 上传区域
|
| 705 |
+
with gr.Group(elem_classes="upload-panel"):
|
| 706 |
+
|
| 707 |
+
image_input = gr.Image(
|
| 708 |
+
type="pil",
|
| 709 |
+
label="📷 上传垃圾图片",
|
| 710 |
+
height=220,
|
| 711 |
+
elem_id="upload-image"
|
| 712 |
+
)
|
| 713 |
+
|
| 714 |
+
username_input = gr.Textbox(
|
| 715 |
+
label="👤 用户名",
|
| 716 |
+
value="default",
|
| 717 |
+
placeholder="输入用户名记录积分"
|
| 718 |
+
)
|
| 719 |
+
|
| 720 |
+
submit_btn = gr.Button(
|
| 721 |
+
"🔍 开始识别",
|
| 722 |
+
variant="primary",
|
| 723 |
+
size="lg"
|
| 724 |
+
)
|
| 725 |
+
|
| 726 |
+
# 识别结果区域
|
| 727 |
+
gr.Markdown(
|
| 728 |
+
"### 🤖 AI 识别结果"
|
| 729 |
+
)
|
| 730 |
+
|
| 731 |
+
result_output = gr.HTML(
|
| 732 |
+
value="""
|
| 733 |
+
<div class='empty-card'>
|
| 734 |
+
<h2>📷 等待上传图片</h2>
|
| 735 |
+
<p>上传垃圾图片后点击「开始识别」</p>
|
| 736 |
+
</div>
|
| 737 |
+
"""
|
| 738 |
+
)
|
| 739 |
+
|
| 740 |
+
# Tabs
|
| 741 |
+
with gr.Tabs():
|
| 742 |
+
|
| 743 |
+
with gr.Tab("📋 投放指南"):
|
| 744 |
+
knowledge_output = gr.HTML(
|
| 745 |
+
value="""
|
| 746 |
+
<div class='empty-card'>
|
| 747 |
+
等待识别结果...
|
| 748 |
+
</div>
|
| 749 |
+
"""
|
| 750 |
+
)
|
| 751 |
+
|
| 752 |
+
with gr.Tab("📊 环保统计"):
|
| 753 |
+
stats_output = gr.HTML(
|
| 754 |
+
value="""
|
| 755 |
+
<div class='empty-card'>
|
| 756 |
+
等待识别结果...
|
| 757 |
+
</div>
|
| 758 |
+
"""
|
| 759 |
+
)
|
| 760 |
+
|
| 761 |
+
# 按钮事件
|
| 762 |
+
submit_btn.click(
|
| 763 |
+
fn=classify_and_advise,
|
| 764 |
+
inputs=[image_input, username_input],
|
| 765 |
+
outputs=[
|
| 766 |
+
result_output,
|
| 767 |
+
knowledge_output,
|
| 768 |
+
stats_output
|
| 769 |
+
]
|
| 770 |
+
)
|
| 771 |
+
|
| 772 |
+
|
| 773 |
+
# --------------------------------------------------
|
| 774 |
+
# 启动
|
| 775 |
+
# --------------------------------------------------
|
| 776 |
+
def launch_gradio(server_port=7860):
|
| 777 |
+
|
| 778 |
+
print(
|
| 779 |
+
f"🌐 Gradio Web 界面: http://localhost:{server_port}"
|
| 780 |
+
)
|
| 781 |
+
|
| 782 |
+
demo.launch(
|
| 783 |
+
server_name="0.0.0.0",
|
| 784 |
+
server_port=server_port,
|
| 785 |
+
share=False
|
| 786 |
+
)
|
| 787 |
+
|
| 788 |
+
|
| 789 |
+
if __name__ == "__main__":
|
| 790 |
+
launch_gradio()
|